Baseball Prospectus の大人気指標 DRC+ についてです。
現 MLB において主要打撃指標である wRC+ と比較して、そのモデル構造から、問題点やバグなど、(構築や管理過程において)無視できない不安定さが DRC+ にはあります。ただ、一介の Aspiring Saberist として、その目的については投合するところがありますので、今一度向き合ってみようと思います。
DRC+ を理解する
まずは、アウトプットによって “Baseball Prospectus の” DRC+ の理解を再度深めておきます。ただ、DRC+ 含め Baseball Prospectus の指標はその複雑性からブラックボックス化している部分が多く、断言できる箇所は多くないというのが現状です。
DRC+ の目的
DRC+ もそうであるように、Baseball Prospectus の指標には「Deserved」という単語が使われていることが多いです。日本語で言うと、「正当な」や「値する」という意味合いであり、この語をわざわざ使うことからも他指標と比較して、外部要因(環境要因や対戦相手の質や運)や不確実性と向き合っている指標ということがうかがえるかと思います。
DRC+ は「Deserved Runs Created」の相対値であり、日本語的には、“打者に帰属すべき”得点創出価値といったところでしょうか。
wRC+ も意味合いとしては似ていますが、“打者に帰属すべき”というニュアンスを付与するにはかなり粗い指標であることは間違いないでしょう。
DRC+ は wRC+ のような既存のボックススコアをそのまま関与打者に帰属させる指標とは違い、打者がその結果にどれだけ寄与したと考えるのが妥当であるかという点について、不確実性も含めて推定します。
ただ、留意点として、Baseball Prospectus はあくまでも「貢献」を推定しているという立場を取っており、能力推定や将来予測に必要となる当人の過去年度の成績等についてはモデルに含めていません。この「貢献」という言葉はその使用頻度の割には、その中身が共有されていないという認識です。決して少数派ではない思想として、『運も含めてその選手の貢献だ』という表現やそれに類するものが散見されますが、自身としては、過去にそういう時期もあったと思いますがそれに異論を持っています。
貢献や価値は対象選手がその結果に(関与だけでなく)寄与した総量の表現だというのが持論であり、これは DRC+ を含め Jonathan Judge が関わる各指標の根底にある思想と近いものがあります。
部分的には見解を異にする部分もありますので、Baseball Prospectus の DRC+ を深く理解した後に、自身の DRC+ も構築できればと思います。
DRC+ の構造
DRC+ の構造は wRC+ のそれとは違います。
初期に公開された基本的な構造としては、各打席結果について二項モデルを構築し、それらから打席イベントの多項分布を構成し、得点価値への変換を行うという形です。本塁打確率モデルや三振確率モデルといった各モデルに打者ランダム効果を含め、最終的には各打者について、本塁打が 4%、三振が 25% などという多項分布で表現するということです。
各打席結果を得点価値で加重した wOBA を、球場やリーグ・シーズンの得点環境によって調整する wRC+ に対して、DRC+ は得点価値化の前段階で、各打席結果の発生確率と、それに含まれる打者の寄与を推定します。この違いは、後述する環境要因や運との向き合い方の違いにもつながります。
また、こちらも後述しますが Stan への移行で、これらの基本構造の機序は変化している可能性があります。ただ、打席結果を多項的に捉え、それぞれの発生確率に対する打者の寄与を推定するという基本的な考え方は共通しているものと考えられます。
具体的な算出過程
算出過程について、公開範囲から簡潔にまとめます。ただ具体的な算出過程が確認できる記事(Judge 2019b)は Stan への移行前のものですので、この算出過程は現在のものとは違うものとして捉えていただければと思います。
①イベント別の二項データを作成する
インプレーアウトを基準カテゴリーとして、三振、四球、死球、失策出塁、単打、二塁打、三塁打、本塁打について、それぞれ「当該イベントかインプレーアウトか」を表す二項データを作成します。
インプレーアウトを基準としているのは、各イベントに共通する比較対象が必要であり、最も頻度の高いカテゴリーを選んだということで、インプレーアウトでなければ理論上成立しなわけではなく、近年では特に三振でも機能するはずです。また、単純に全打席に占める割合で回帰しても問題はないですが、その後の多項分布への統合を考えると、基準となる共通の比較対象を設定する方が良いという判断です。
②イベント確率モデルを予備推定する
各イベント確率モデルについて、高速な glmer() で実行します。
以下、コード例は 2019年公開時点における、本塁打確率モデルです。
library(lme4)

### initial model run

glmer.23.mod.0 <- glmer(
  outcome ~
    (1|pitcher) +
    (1|batter) +
    (1|stadium_bats) +
    pit_hit + temp_sc + TTO +
    p_gb_rate_sc,
  data=df.cd2.cd23,
  family="binomial",
  control = glmerControl(optimizer = "nloptwrap"),
  nAGQ=0)

### harvest fixed effect coefficients

glmer.23.fixef <- fixef(glmer.23.mod.0)
ここでは、打者評価を得ることではなく、固定効果の係数を推定し、この後の本推定における事前分布を設定することを目的とします。
③事前分布を導入してイベント確率モデルを本推定する
予備推定の結果から固定効果の事前分布を設定し、bglmer() で各イベント確率モデルを実行します。
library(blme)

glmer.23.mod <- bglmer(
  outcome ~
    (1|pitcher) +
    (1|batter) +
    (1|stadium_bats) +
    pit_hit + temp_sc + TTO +
    p_gb_rate_sc,
  data=df.cd2.cd23,
  family="binomial", fixef.prior = normal(sd=c(10, as.numeric(glmer.23.fixef[2:length(glmer.23.fixef)]))),
  cov.prior = list(batter ~ invgamma(shape=.5, scale=10), NULL),
  control = glmerControl(optimizer = "nloptwrap"),
  nAGQ=1)
上記モデルのランダム効果、固定効果については後述します。
④打者ランダム切片を残して各イベントを予測する
推定した各モデルを適用し、打者ランダム切片を残した予測値を求めます。
df.preds <- DRC_data

df.preds$cd23_all_lp_bat <- predict(glmer.23.mod, newdata=df.preds,
                                    allow.new.levels = TRUE, type='link',
                                    re.form=~(1|batter))
ただ、このコードの仕様では固定効果を除外しないはずですので、ランダム効果のうち打者ランダム切片だけ残しているという状態です。この点については、疑問が残りますが現在の仕様は変わっている可能性もあります。
⑤イベント別の予測を多項確率分布へ統合する
各二項モデルの予測値を softmax 変換によりインプレーアウトを含む全イベントの確率の合計が 1 になるように変換します。
model.coef.final <- df.preds %>%
  dplyr::mutate(
    K_all = 1 +
      exp(cd3_all_lp_bat) +
      exp(cd14_all_lp_bat) +
      exp(cd16_all_lp_bat) +
      exp(cd18_all_lp_bat) +
      exp(cd20_all_lp_bat) +
      exp(cd21_all_lp_bat) +
      exp(cd22_all_lp_bat) +
      exp(cd23_all_lp_bat),
    cd2_all = 1 / K_all,
    cd3_all = exp(cd3_all_lp_bat) / K_all,
    cd14_all = exp(cd14_all_lp_bat) / K_all,
    cd16_all = exp(cd16_all_lp_bat) / K_all,
    cd18_all = exp(cd18_all_lp_bat) / K_all,
    cd20_all = exp(cd20_all_lp_bat) / K_all,
    cd21_all = exp(cd21_all_lp_bat) / K_all,
    cd22_all = exp(cd22_all_lp_bat) / K_all,
    cd23_all = exp(cd23_all_lp_bat) / K_all
  )
これにより、各打者について三振、四球、単打などの推定発生確率からなる一つの分布を得ます。
⑥リーグ平均との差を得点価値化して DRC+ へ変換する
打者ごとの推定イベント確率とリーグ平均のそれとの差と得点価値を掛け合わせ、リーグ平均に対する各打者の得点貢献を求め、リーグ平均が 100 になるように尺度化し、最終的な DRC+ を算出します。
ざっと説明してみました。では次節から、既存指標との大きな違いとなる、環境要因や運との向き合い方について、少し掘り下げます。
環境要因・対戦相手の質との向き合い方
対象選手の寄与を測るためには、環境要因や対戦相手の質といった外部要因と向き合う必要があります。
環境変数という表現が、特に wRC+ においてはニュアンスが近いと思いますが、いろいろ紛らわしいので、環境要因と表現しています。
これは、多くの野球ファンが受け入れている観点での補正だと思います。OPS や ERA で評価している一ファンに、球場や対戦相手の質という変数を制御するべきという主張を一ファンがしている光景はしばしば目にします。
wRC+ は要因の分解というよりは、得点環境の補正という意味合いですが、球場やシーズン・リーグという外部要因と向き合っています。先述しましたが、DRC+ はその変数を調整する段階が変わり、またその対象を広げます。
補正対象が多岐にわたる
先ほど例示したように、本塁打確率モデルについては過去に公開(Judge 2019b)されています。そのモデルに組み込まれている打者ランダム切片以外の変数は以下です。
投手
(1|pitcher):対戦投手ごとのランダム切片球場 × 打席左右
(1|stadium_bats):球場と打者左右の組合せごとのランダム切片投手の打席
pit_hit:打者が投手かどうかを表す固定効果試合開始時の気温
temp_sc:尺度調整した気温の固定効果対戦投手の周回数
TTO:同一試合での対戦打者数から区分した巡回数の固定効果対戦投手の推定ゴロ率
p_gb_rate_sc:別モデルで推定し、尺度調整したゴロ率の固定効果
TTO は同じ打者との対戦回数ではなく、投手の同一試合における対戦打者数が 1 ~ 9 人目までを一巡目、10 ~ 18 人目を二巡目、19 人目以降を三巡目として分類しています。
推定ゴロ率はサンプルサイズと対戦打者の違いを考慮した GB ~ (1 | pitcher) + (1 | batter) という二項ロジスティック混合モデルです。ただ対象データの具体的な抽出条件は公開範囲からは確認できていません。
wRC+ と比較して、考慮している外部要因は多いです。本塁打確率モデルですので、本塁打確率に関わる要素が選ばれています。
細かい部分に少し触れると、投手の打席を考慮する固定効果があるのに対して、野手登板を表す固定効果がないのは時代を感じます(記事の公開は 2019年)。野手登板は投手登板とは水準が全く異なりますので、このモデルでは野手登板は投手の水準に強く縮小してしまいます。
また、ここは細かいようで設計者の思想として議論に深みが出る箇所だと常々思っているのが、「球場 × 打席左右」です。wRC+ は打席左右の PF の違いを考慮していないのは有名です。その球場において、その打席に立ったという貢献を打者に帰属している状態です。
DRC+ は、公開されている本塁打確率モデルにおいては、この左右差を打者の貢献から差し引きます。自身としては、この点については支持します。例えば、フェンウェイパークで左打者を起用すること自体については首脳陣の貢献として計上すべきだと考えているということです。
ただ、Baseball Prospectus のモデルでは、リーグ全体として打席左右における傾向に違いが見えたとき、その差を分離しないため、その効果の一部が打者の貢献から控除される可能性があります。例えば、三塁打確率モデルにも同じ「球場×打席左右」の項を用いるとします。特定の球場に限らず、リーグ全体で左打席の三塁打確率が右打席より高い場合でも、その差の一部が「球場×打席左右」の効果に配分され、打者効果から差し引かれる可能性があるということです。
少し話が逸れましたが、DRC+ は既存の類似指標と比較して、環境要因や対戦相手の質といった対応する外部要因が多岐にわたるということが分かると思います。
補正項を発生確率モデルの段階で組み込む
wRC+ と比較するとその補正項の種類以外にも、その補正の組み込む過程に違いがあります。
先に述べたように、DRC+ は各イベントの発生確率を推定する段階で、各要素の補正をモデルに組み込みます。打席結果を得点価値化し、その集計値に平均的な球場補正を加える wRC+ に対して、DRC+ は打者効果を外部要因と同時に推定しようとします。
補正する要素が同じなら、理論的にはこの補正段階の違いが影響を及ぼさない条件はあるものの、実態としては、まず間違いなく打者によって補正量が変化します。
公開されているロジスティックモデルでは、球場などの効果を全打者に共通する対数オッズ上の変化として推定しますので、同じ変数の補正であっても、確率に換算したときの調整量は打者固有の基礎的なイベント確率によって変わります。
ただ、これはあくまでも確率に換算することによる変化ですので、例えば、中距離打者ほど本塁打確率に影響が大きいというような非線形な交互作用を捉えている仕様ではありません。公開範囲からはそのような柔軟な補正をしていることは確認できませんが、Stan への移行や Statcast データの活用によって、より柔軟な階層モデルを構築しやすくなっていることは確かです。
また、得点価値として一元化する wRC+ と違い、各イベントの発生確率モデル内で補正項を組み込む DRC+ では、イベント別特性と打者のイベント構成の組み合わせによって、総合的な得点価値の調整量も変わります。
得点の入りやすさは同じ球場であっても、その内訳(単打が出やすい、本塁打が出やすいなど)が違うことは多々あります。wRC+ では全打者に対して標準的な球場補正がされるのに対して、DRC+ では各イベントの発生確率を個別に調整するため、同じ総合得点価値の打者であっても、そのイベント構成に応じて補正後の得点価値が変わります。
これは先述した「球場×打席左右」の補正項と同じく、単打になりうる打球が多い打者が単打の出やすい球場でプレーしたという貢献を、その打者に与えるか、打者以外に与えるかという選択肢において、後者を取っているという状況です。
運・不確実性との向き合い方
前節の球場や対戦相手の質などの外部要因と比較して、「運」という外部要因の補正は、貢献という文脈では、多くの野球ファンには受け入れられていないという認識です。また、軽く見られがちな不確実性についてもまとめます。
運との向き合い方
四球や二塁打といった(あくまでも便宜的にすぎないはずの)結果をそのまま活用する wRC+ と比較して、DRC+ はロジスティックモデルを使うことからも、結果には確率的変動があるという考えが表現されていると言えます。そしてランダム効果や事前分布による推定が、その変動をどの程度打者に帰属させるかを調整します。
この素の結果と推定された結果の差を「運」と捉えると、その運はモデルの不確実性の考慮も相まって、本人に帰属させないことへの抵抗も大きくなり、多くの野球ファンが支持する「運も含めてその選手の貢献」という思想につながるのではないかと思います。
野球以外の分野でも貢献という文脈において、運の扱いは意見が分かれるところでもあります。運を貢献に含める理由の一つにこのモデルの不確実性や測定コストがあります。
ただこれは素の結果をゴールにしているが故に起こる考え方であり、ゴールを「真のイベント確率」のようなものと見なせば、素の結果も DRC+ 等で推測したイベント確率も同じ推定値と見なせます。その立場を取ると、観測できない「真のイベント確率」から運を取り出すことが難しくなるので、外部要因でありながら観測できない「運」という要素を貢献として扱うということに慎重にならざるを得なくなります。
ERA も FIP も同じ勝利貢献推定値であり、サイヤング投票は ERA を重視するという指針に合理性はないというのと同じ考えです。
つまり、端的に述べるなら、DRC+ は「打者に帰属すべき貢献」の推定値ですので、そこに「運を差し引く / 含める」といった作業は存在しません。ただ、素の結果に含まれる確率的な変動、いわゆる「Random Variation」の影響を弱めるという意味では、運の影響を調整するモデル構造になっています。
Random Variation との向き合い方
DRC+ は打者効果をランダム効果として部分プーリングすることで Random Variation に対処しています。各打者に独立した無正則化の固定効果を置く場合とは異なり、各打者を打者という集団に属する一個体として扱います。これにより、各打者の情報だけでなく、打者という集団の情報も打者効果の推定に利用されます。
その結果、打席数が少ない打者ほど平均に強く縮小させ、打者間の持続的な差が小さいイベント(失策出塁など)ほど強く縮小させながらも、十分な打席数と極端な成績を持つ打者は平均から離れることを許容されます。
ちなみに、ここで平均へ縮小された部分は運そのものというよりは、このモデルの下で打者固有の効果として十分に帰属されなかった部分であるというニュアンスです。
また Stan への移行で事前分布の形や打者間分散の推定は変わっている可能性はありますが、縮小や懐疑主義が DRC+ の中心という態度は崩されておらず(Judge 2021b)、部分プーリング自体は現在も残っているものと考えられます。
推定の不確実性との向き合い方
不確実性と一口に言っても、いろいろな種類の不確実性が思い浮かぶと思います。先ほど扱った Random Variation も不確実性と言えますし、それとは別に、その推定の不確実性やモデル構築そのものの不確実性があります。
モデル構築そのものの不確実性は DRC+ が過去に行ってきた数多くのアップデートにも表れていますが、こちらについては別モデルとの比較検証が必要であり、DRC+ が表現できる範囲の外にあります。
推定の不確実性について DRC+ は表現しています。到底日常使いできないほど重いことで有名なBaseball Prospectus のリーダーボードにある「DRC+ SD」ですね。2019年時点では、この DRC+ SD を CSAA と同じく Bayesian Bagging という手法によって算出しています。
手法の細部まで CSAA と同じかどうかは確定できません。CSAA は投球単位の指標であり、リサンプリングの手順が違う可能性は十分にあります。
ただ、Stan を用いた完全ベイズ推定への移行で Bayesian Bagging とは違う手法でこの不確実性を推定している可能性は高いです。観測データのリサンプリングが肝である Bayesian Bagging に対して、観測データを固定し、事前分布と尤度からなるパラメータの事後分布をサンプリングすることが肝である Stan での事後標準偏差の算出では、その前提と不確実性を得る手段が違います。
現行の DRC+ SD の具体的な算出方法を公表していない時点で、打者の真の貢献の不確実性として、どの程度依拠できるかについては語りづらいのが現状です。
過去のモデル更新
では最後に、過去のモデル更新について列挙しておこうと思います。
2019年 球場効果の問題と極端な打撃成績への対応(Judge 2019a)
打者の推定値から球場効果を分離する処理を修正。
極端な単打率などを平均へ縮小しすぎる問題に対して、該当するモデルの打者効果の分散に逆ガンマ事前分布を導入。周辺年度の個人成績も利用する手法を検討したものの、採用せず。
2021年 Statcast データを利用した球場補正(Judge 2021a)
打球情報や気温から球場効果を推定した球場補正を算出。DRC+ への反映が宣言されているものの、モデル内部で球場効果を推定する 2019年公開時の DRC+ との整合性の取り方には疑問が残る。
2021年 Stan への移行(Judge 2021b)
DRC と DRA のコード基盤を統合し、モデルを Stan を用いるベイズ推定へ移行(詳細なモデル式等は公開されていない)。
近年のリーグ全体のイベント発生確率に関する事前知識も推定に取り入れている。
2023年 Statcast データをモデル入力の段階で導入(Judge 2023)
DRC と DRA のモデル入力の段階で Statcast の打球データの利用を開始。本塁打や単打の推定に利用するとされている。
2024年 インプレーアウトの得点価値に関する修正(Judge 2024)
単一アウトと複数アウトの打球に対する計算ミスを修正。以前はインプレーアウトの減点が不足しており、アラエスのような打者の過大評価、ジャッジのような打者の過小評価を修正。
記憶では、この修正によりイチローの DRC+ が上方修正されました。ただ、逆ガンマ事前分布の問題点について、統計畑ではよく指摘されているのを聞きます。記事内では、更新された DRC+ の一貫性が更新前を下回っていないという検証結果を示し、モデルが劣化する安易な変更ではないという立場を取っています。
列挙してみましたが、漏れがある可能性、公開されていない更新があった可能性はあります。これらからも分かるように、DRC+ は比較的明瞭な他指標と比較してモデル構造自体の更新が多いです。
この特徴は強みとも弱みとも言えますが、完成しないこの指標はセイバーメトリクス愛好家からすれば、味のし続けるガムのようなもので、自身で完成に向けて試行錯誤できる恰好のおもちゃとも言えるかもしれません。
ということで、次の章では自身が納得できる DRC+ の構築に進みます。
DRC+ を構築する
前章で述べてきたように、Baseball Prospectus の DRC+ は目的は共感できる一方で、特に現行モデルではその中身が公開されていません。そこで、同じ目的を持つ打撃指標を、前章で触れた疑問点や見解を異にしていた部分も解消しながら作っていきたいと思います( Stan も使ってみたかったですし)。
馴染みのある glmer() のような混合モデルではなく Stan を使う理由はいくつかあります。ロジットから確率への変換や、確率の掛け合わせのような、パラメータの非線形な組み合わせにもそのまま区間が付くこと。分布を得るベイズ推定では、打者間の差が小さいモデルでも標準偏差が 0 に張り付かないこと。打者の分布を変えたり、その形を別モデルで推定した値で渡したりといった自由があることなどです。
ちなみに、前章は自身の DRC+ の構築に取り掛かる前の段階で書き上げていますので、この構築の章で新たに見えたもの、理解度が上がったものなどもあります。また、当然ではありますが、(とりあえずの)完成までにそこそこ試行錯誤もありましたので、そこもなるべく網羅して書き起こしてみます。どうせ自分のブログなので。
何が言いたいかというと、前章含めて簡潔になどまとまっていない記事ですが、大事な情報や考察は記事全体に散らばっているという、読み手にとってはあまり嬉しくない注意喚起をこのタイミングでしてみたということです。
方針
まずは方針を決めておきます。
何を推定するか
最初に、推定する量を決めますがここは Baseball Prospectus と大きくは変わらないはずです。
打者 i について、
\theta_i = \sum_{k} p_{ik}^{\text{中立}} \, \bigl( w_k + \delta_{ik} \bigr)
を推定の対象とします。k は打席結果のカテゴリ(三振、四球、本塁打など)、p_{ik}^{\text{中立}} は「その打者をリーグの平均的な環境に置いたときに、結果 k が起きる確率」、w_k は結果 k の得点価値です。\delta_{ik} は、打者 i のイベント k が、平均的な同じイベントよりどれだけ価値が高いか(低いか)を表します。詳しくは「得点価値の補正」の節で述べます。
最後にリーグ平均を 100 とする尺度に直します。
\text{自作 DRC+}_i = 100 \times \left(1 + \frac{\theta_i - \theta_{\text{lg}}}{\text{R/PA}}\right)
ちなみに、これは wRC+ でも同じですが、ここで言うリーグ平均は野手の打席数で重みづけた平均です。打席結果の確率を先に推定し、そのあとで得点価値を掛けるという流れは Baseball Prospectus の DRC+ と変わりません。
Baseball Prospectus に同調する部分
改めて、Baseball Prospectus に同調する部分を確認しておきます。
その年の貢献を推定する
あくまでもその年の貢献を推定することを目的とし、能力推定や将来の予測というニュアンスが切り離せなくがちな本人の過去や翌年の成績は使いません。また、ルールや環境の年ごとの変化を自動的に吸収できるという点も実務的には楽な部分です。
打者の効果は部分プーリングで推定する
打席数の少ない打者や、打者間の差が小さいイベントほど、平均に強く寄せます。詳細については後述しますが、「帰属すべき」という意味合いがある指標の核となる考えです。
外部要因は、確率を推定する段階で調整する
一般的なセイバーメトリクス指標と違い、得点価値に直してから一律に補正する手順は取りません。こちらも後述しますが、より柔軟かつ合理的な外部要因の調整がしやすくなります。
不確実性も推定する
ベイズ推定により、パラメータが事後分布として得られますので、それを推定値の不確実性の表現に活かします。
「本人の過去や翌年の成績は使わない」という点について留意点ですが、あくまでも個人としての他の年の成績のことであり、打者という集団についての情報は複数のシーズンから得ます。例えば、「三振を極端にしない打者は、正規分布が想定するより多い」という分布の形や、「本塁打の多い打者は三振も多い」という特徴は、特定の打者の情報ではなく母集団の性質です。こうした値は今回 6 シーズンの合計から推定しました。Baseball Prospectus もこのような使い方をしています(Judge 2021b)。
Baseball Prospectus と異なる部分
違う選択をした(可能性がある)のは次の点です。それぞれ、後の節で詳しく書きます。
逐次的な二項モデルで表す
Baseball Prospectus(2019年公開)のような、各イベントを「そのイベントか、インプレーアウトか」の二項モデルにして softmax でまとめる代わりに、応用や修正のしやすい 8 段階の「木」に分けます。
中立環境は、実際の打席の集まりで定義する
Baseball Prospectus のように、「環境の効果を 0 と置く」のではなく、リーグで実際にあった打席の環境に全打者を置いて平均します。前章で述べた、打者効果の推定で気温などの環境の固定効果も残さないようにします。
イベント間の相関を使う
本塁打の多い打者は三振も四球も多い、という母集団の情報を縮小に使います。各二項モデルの縮小先が、その打者の他の二項モデルでの結果から予想される値になるというイメージです。
得点価値の違いを補正する
本家 DRC+ でも単一アウトと複数アウトの価値の違いは捉えていましたが、それ以外にも内野安打と外野への単打の違いやゴロアウトとフライアウトの違いなど、同じアウトや単打でも価値には違いがあります。打者ごとに見ると、その価値の違いは安定しないものも多いですが、中にはバイアスとして一貫して表れるものもありますので、それらを補正します。上記式における \delta_{ik} 項です。
縮小を弱めるための事前分布(逆ガンマ)は入れない
先述した 2019年の更新(Judge 2019a)で Baseball Prospectus が導入したものです。極端な打者への対処は、縮小の強さをいじるのではなく、打者の分布の形と Statcast データの利用で行っています。
逐次的な二項モデルの基本構造
Baseball Prospectus の公開された版では、各イベントについて「そのイベントか、インプレーアウトか」の二項ロジスティック混合モデルを別々に作り、最後に softmax で合計を 1 にそろえていました。
自作版では、打席結果を次の順に 1 つずつ切り出していく形にしました。
| 段階 | 確率を推定するイベント | 分母になる打席 |
|---|---|---|
| ① | 死球 | すべて |
| ② | 四球 | 死球以外 |
| ③ | 三振 | 四死球以外 |
| ④ | 本塁打 | 打球(BBE)が発生した打席 |
| ⑤ | 失策出塁 | BIP が発生した打席 |
| ⑥ | アウト(BIP) | 失策出塁以外の BIP |
| ⑦ | 単打 | BIP 安打 |
| ⑧ | 三塁打 | 二塁打・三塁打 |
各段階は「そのイベントか、(その段階に残っている)他のイベントか」の二項モデルです。各段階は、分母になる打席から、「切り離すイベント」と「次の段階へ進むイベント」の 2 つに分けるだけなので、9 つのカテゴリの確率は合計が必ず 1 になります。softmax でまとめる方法と違い、後からの調整は要りません。
ちなみにモデルの上では、解釈性という面から、⑥は「安打(BIP)になる確率」、⑦は「長打(二塁打・三塁打)になる確率」を推定しています。2 択なので、どちらを推定対象にしても、係数の符号が逆になるだけで同じです。
この構造にした理由はいくつかあります。
段階ごとに異なるスキルに対応できる
Baseball Prospectus の形でもできないことはないですが、前章で説明したモデルでは、「そのイベントか、インプレーアウトか」の比を測ります。推定対象だけでなくインプレーアウトの情報が入る手法と比較して、この手法では、段階ごとに異なるスキルへの対応がより直接的にできます。
段階ごとに使うデータを変えられる
後述しますが、④⑥⑦には Statcast データを使い、他の段階には使いません。Baseball Prospectus の形でも使えますが、例えば「打球のうち本塁打になる割合」を推定するような、この手法の方がより直接的に打球モデルを目的変数にできます。
計算を分けても近似にならない
この手法なら、段階ごとに推定した結果は、全体を一度に推定した結果と一致します。MCMC を使う以上、我々庶民のPC環境ではモデルを分割するのが現実的ですので、この点も無視できません。これにより、後々修正したい箇所が出てきたら、一部だけやり直すこともできます。
たとえば死球の段階だけを改良したい場合、回し直すのは死球の段階と、その後の後処理だけです。
ちなみに、この「木」の順序は一意には決まらず、順序そのものがモデルの仮定と言えます。入れ替えの組み合わせは多く候補がありますが、結果がどれだけ変わるかは網羅していません。
ノート【参考】順序の決め方
木の順序に定理はなく、一意には決まりませんが、以下を基準としました。
打席の進み方に沿う
ピッチモデリング指標でも似た分岐を仮定することが多いように、スイング判断で決定する四死球を先に、その後のスイング結果から決まる打球の結果を後に置くという野球的な機序です。
1 つの分岐が 1 つのスキルに対応する
これは主観性が強くなりがちなので、注意が必要ですが、各段階で打者の効果を測っていくわけですから、その分岐に対応するスキルが(できるだけ明瞭的に)ある方が好ましいです。例えば、全打席から三塁打の確率を推定すると、その中には三振回避や四球奪取、本塁打を打つスキルなども混在します。その点、打席あたりの死球や打球あたりの本塁打などは、比較的対応するスキルに明瞭性があると考えました。
段階どうしが独立に近い
段階ごとに別々に推定するので、段階の間に強い関係が残らない切り方が効率性という面で望ましいです。これは 2 を守ると減らせますが、2 を守っても消えない相関はありますので、後に述べるように別途対処します。
迷ったらデータで比べる
実務的には大変ですが、実際にモデルを回して検証します。
三振のモデルで土台を固める
全段階を一度に作らず、2021 年の三振の段階だけを使って、モデルの土台を固めました。三振は数が多く、打者間の差もはっきりしているので、共通となる枠組みの検証に使いやすいです。
打者と投手だけ
打者と投手のランダム効果だけを入れた最小のモデルから始めました。
収束しましたが、切片から計算した三振確率(四死球を除いた三振確率であることに注意)が約 30% で、実際のリーグ全体(26%)より高く出ていました。切片は打者という集団の中心であって、打席数で重みづけた平均ではないことからも当然ではあります。打席数の少ない打者(投手を含む)ほど三振が多いので、単純平均は高くなります。これにより、効果を 0 と置いた打者を平均的な打者とみなす危険性が確認できました。
もう一つの問題は投手の打席です。投手の実際の三振率は 51% ですが、全打者として共通の平均に引き寄せられ、推定値の平均は 37% でした。
投手の打席と打席の左右
投手の打席を表す固定効果を入れると、係数は +1.19、確率にして野手の三振確率 25% を基準として約 52% と、実際の投手の三振確率(51%)に近くなりました。打者間の標準偏差も小さくなり、「投手と野手の違い」を捉えられるようになりました。
また、プラトーンのタイプもここで入れました。周知の通り、右 vs 右、左 vs 左のような同利き手のプラトーンでは三振は増えますが、これは対戦相手との組み合わせで決まる環境の要因と言えます。
一方、左打席そのものの効果は、打者の属性です。前章で触れたとおり、Baseball Prospectus の「球場 × 打席左右」の項は、リーグ全体の左右差の一部を環境要因に配分してしまう可能性があります。自作版では、左打席の主効果を固定効果として明示的に入れ、推定値を作るときには本人の値のまま残します。左打席に立つことで生じる差は、打者に帰属させるという立場です。
スイッチヒッターの中には、場合によっては左投手に対して左打席に立つような打者もいますので、「左打ち・右打ち・両打ち」のような分類ではなく、投手の左右ごとに、本人が実際にどちらの打席に立ったかの割合をそのまま使う形にしました。
捕手と球審
三振は捕手のフレーミングと球審の特徴に影響を受けますが、効果としては大きくありません。実際に説明変数に入れたときの、各ランダム効果の標準偏差は投手や打者の 15 分の 1 以下でした。
上記は打席単位の影響度ですので、1 シーズン単位で見るとさらに影響力は小さくなります。200 打席以上の 344 人について、入れる前と後の打者の推定値を比べると、相関は 1.000、最大の変化は確率にして 0.2% 未満で、推定の不確実性の 13 分の 1 でした。計算時間やモデルの安定性も加味した結果、これらの変数は採用しません。
空振り三振と見逃し三振を分けることも検討しましたが、上記からその恩恵が少ないと予想でき、今回の逐次的な二項モデルの中で得点価値の同じイベントを細分化する合理性が低いと判断しました。
球場、気温、塁アウト状況、疲労、慣れ
次に、球場、気温、塁アウト状況、投手の疲労(投球数)、慣れ(同じ打者との対戦回数)をまとめて入れました。Baseball Prospectus の TTO は「その試合で何人目の打者か」で区切っていますが、これには疲労と慣れの 2 つの効果が混ざっているので、分けて入れています。
打席単位ではどれも効果として十分に大きいです。
| 変数 | 三振への効果(ロジット) | 三振確率(四死球を除く打席あたり)の変化 |
|---|---|---|
| 球場 | Coors Field −0.18、Tropicana Field +0.16 | Coors Field -3.3%、Tropicana Field +3.2% |
| 気温 | 10°C ごとに −0.063 | 10°C ごとに -1.2% |
| 塁アウト状況 | 標準偏差 0.11 | 1 標準偏差あたり ±2% |
| 投手の疲労 | 25 球ごとに −0.045 | 25 球ごとに −0.9% |
| 慣れ | 2 回目 −0.10、3 回目以降 −0.14 | 2 回目 −1.9%、3 回目以降 −2.6% |
ただ、年間で考えるとどれも効果は均されます。以下が、各変数が 200 打席以上の打者の評価をどれだけ動かすかを示した表です。
| 変数 | 打者間の差(標準偏差、ロジット) | 判断 |
|---|---|---|
| 球場 | 0.033 | 採用 |
| 気温 | 0.008(最大 0.029) | 採用 |
| 塁アウト状況 | 0.005 | 不採用 |
| 投手の疲労 | 0.004 | 不採用 |
| 慣れ | 0.006 | 不採用 |
目安にしたのは 0.013 で、推定の不確実性の 1 割ほどにあたります。塁アウト状況・疲労・慣れは、最も不利な打者(代打の多いサンドバルなど)でも、3 つ合わせて 0.04 でした。効果の小ささと計算の重さを比べて、外しました。気温は一部打者には無視できない差になる、裾の重い分布ですので採用しています。
この確認は三振の段階で行ったものです。他の段階で同じ結論になるかは、確かめていません。
中立環境の考え方
先に述べたように、効果を 0 と置く手法では平均的な環境は構築できません。これは、効果が 0 の投手は平均的な投手ではないという点と、ロジスティック曲線の形からも分かるように、三振確率のような基準が 50% ではない場合には、先にロジットを平均してから確率に直す手法ではズレが生じる点が理由です。
そこで、リーグで実際にあった打席から環境をそのまま抜き出し、全打者をその環境に 1 つずつ置いて、確率を平均する方法にしました。つまり、ここでの環境中立は、その年のリーグで実際にあった平均的な環境を想定します。
暫定版
土台が固まったので、2024 年の全 8 段階を、(Statcast データはまだ使わず)打席結果だけを使って推定しました。各段階の変数についてですが、三振の段階には入れていない「守備チーム」というランダム効果を打球が飛んだあとの段階(⑤〜⑧)にだけ入れています。球場は、打球方向が影響する段階(④⑥⑦⑧)では打席の左右と組み合わせ、それ以外の段階では単独で入れています。
次の節で「分布の形」を扱いますが、その検証には 2021 年より 2024 年の方が相性が良かったので、ここからは 2024 年で検証しています。
段階ごとの打者間の標準偏差
以下が、段階ごとの打者間の標準偏差です。
| 段階 | 対象となる確率 | 打者間の標準偏差 |
|---|---|---|
| ⑧ | 三塁打 / 二塁打・三塁打 | 0.61 |
| ① | 死球 / 全打席 | 0.58 |
| ④ | 本塁打 / BBE | 0.48 |
| ③ | 三振 / 四死球以外の打席 | 0.38 |
| ② | 四球 / 死球以外の打席 | 0.31 |
| ⑦ | 単打 / 安打 | 0.19 |
| ⑤ | 失策出塁 / BIP | 0.12 |
| ⑥ | アウト / 失策以外の BIP | 0.097 |
「BIP のうちアウト / 安打となる確率」の小ささが目立ちます。450 個の BIP があっても、実際の結果の半分しか推定値に残りません。BABIP の不安定さが、そのまま数字に出ています。
固定効果も大方想定通りで、死球は投手と左右が同じ打席で増え、失策出塁は左打者で減り、三塁打は左打者で増えます。
最初の指標
得点価値は、そのシーズンの各イベントの得点価値の平均を使いました。300 打席以上の打者で標準偏差を見ると以下です。
| 暫定版 | wRC+(FG) | DRC+(BP) | |
|---|---|---|---|
| 標準偏差 | 16.8 | 24.0 | 20.0 |
暫定版と DRC+ の相関は 0.90 でした。上位打者は強く縮小され、ジャッジは 183(wRC+ 220、DRC+ 218)です。アラエスは単打の確率が実際の 24.1% から 21.1% に下がりました。年間で約 20 本分です。
この時点で、2 つ解消したいポイントがありました。
球場の調整が粗い
先にも述べましたが、ロジットに一律の値を足す調整なので、フェンス際の打球が多い打者に影響を強めるなどの調整がありません。トラッキングデータがあるなら、そのデータを活用するのが素直な方法です。
BIP アウトの段階がほとんど平均に縮小される
フリーマンなどが持つスキルを過小評価したくないものの、結果だけを使う限り、これ以上の情報は拾いにくいです。こちらも Statcast データを使うことで改善は図れます。
極端な打者の縮小が過大である可能性
近年のアラエスのような外れ値とも言える打者への対応です。Statcast データが改善につながらない三振などでは分布の形を確認する必要性があります。
打者の分布の形
暫定版では、打者の分布をすべて正規分布にしていましたが、この形が妥当かを確かめます。
打者の効果には最初は正規分布を置いていましたが、2021 年の三振で、200 打席以上の 344 人の推定値の形を見ると、歪度が −0.35 で、三振の少ない側に裾が伸びていました。極端な打者がいない年でもこの形なので、正規分布は三振の少ない打者を縮小しすぎている可能性があります。そこで、違いが表れやすい 2024 年で t 分布を試しました。
結論として、動いたのはアラエスだけと言ってよい結果でした。正規分布から t 分布にすることで、アラエスは -0.8% 動きましたが、クワンやクレメントは -0.3%、その他の打者は ±0.2% の変動に収まっています。極端な打者だけを縮小から少し解放する、という意図どおりの動きではあります。
問題は自由度です。1 シーズンでは情報が足りないので、6 シーズンをまとめたモデル(打者 × シーズンで約 4,000)で、形だけを推定しました。ここが「母集団の情報は複数のシーズンから得る」の一つの例です。
| 段階 | 自由度の推定 | 結果 |
|---|---|---|
| ③三振 / 四死球以外の打席 | 約 12(90% 区間 8.5〜17.5) | 歪度 −0.56、尖度 1.22 |
| ⑥アウト / 失策以外の BIP | 約 26(8〜54、事前分布のまま) | 収束が不十分 |
三振は、事前分布(平均 20)からはっきり離れた値になりました。三振の段階では、自由度 12 で固定した t 分布を使います。
三振の少ない側の上位 8 つのうち 5 つは、アラエスの各シーズンでした。裾の重さの証拠の大半が 1 人の打者由来です。
BIP アウトの段階は、正規分布のままとし、極端な打者への対処は Statcast データの利用に委ねます。本塁打の段階も、歪度 0.03・尖度 −0.17 とほぼ正規分布で、t 分布にしてもジャッジが年に 1 本程度動くだけだったので、正規分布のままです。
検証の方法
Statcast データを使う手法に入る前に、モデルの良し悪しを判定する手段を決めておきます。
同じシーズンを半分に分ける
使ったのは、同じシーズンを試合ごとに交互に 2 つに分け、片方で推定した値で、もう片方の実際の成績を予測する方法です。翌年の成績を予測する方法では、年齢や移籍、故障や能力の変化など、「その年の貢献」においては、邪魔になる要素が混ざりやすくなります。同じシーズンでの分割で推定対象と検証対象の一致を図りました。
ベースライン
2024 年の分割した両方に十分な打席がある 262 人で、打席あたりの得点価値を予測した結果です。なお、ここで使った暫定版は打者の分布をすべて正規分布にしたものです。
| モデル | 誤差 | 傾き |
|---|---|---|
| 全員をリーグ平均とする | 0.0371 | — |
| 実際の得点価値をそのまま使う | 0.0406 | 0.35 |
| 暫定版 | 0.0352 | 0.63 |
実際の成績をそのまま使うと、全員をリーグ平均とするより悪い、という結果です。半シーズンの成績には、それだけ偶然が多く含まれています。暫定版はどちらよりも良いですが、傾きが気になります。
傾きは「推定値が 1 高い打者が、もう半分の成績で平均でどれだけ高いか」です。0.63 ということは推定値の差の 6 割ほどしか、もう半分では再現されていません。縮小をかけていますが、まだ差を広く見積もりすぎていることになります。
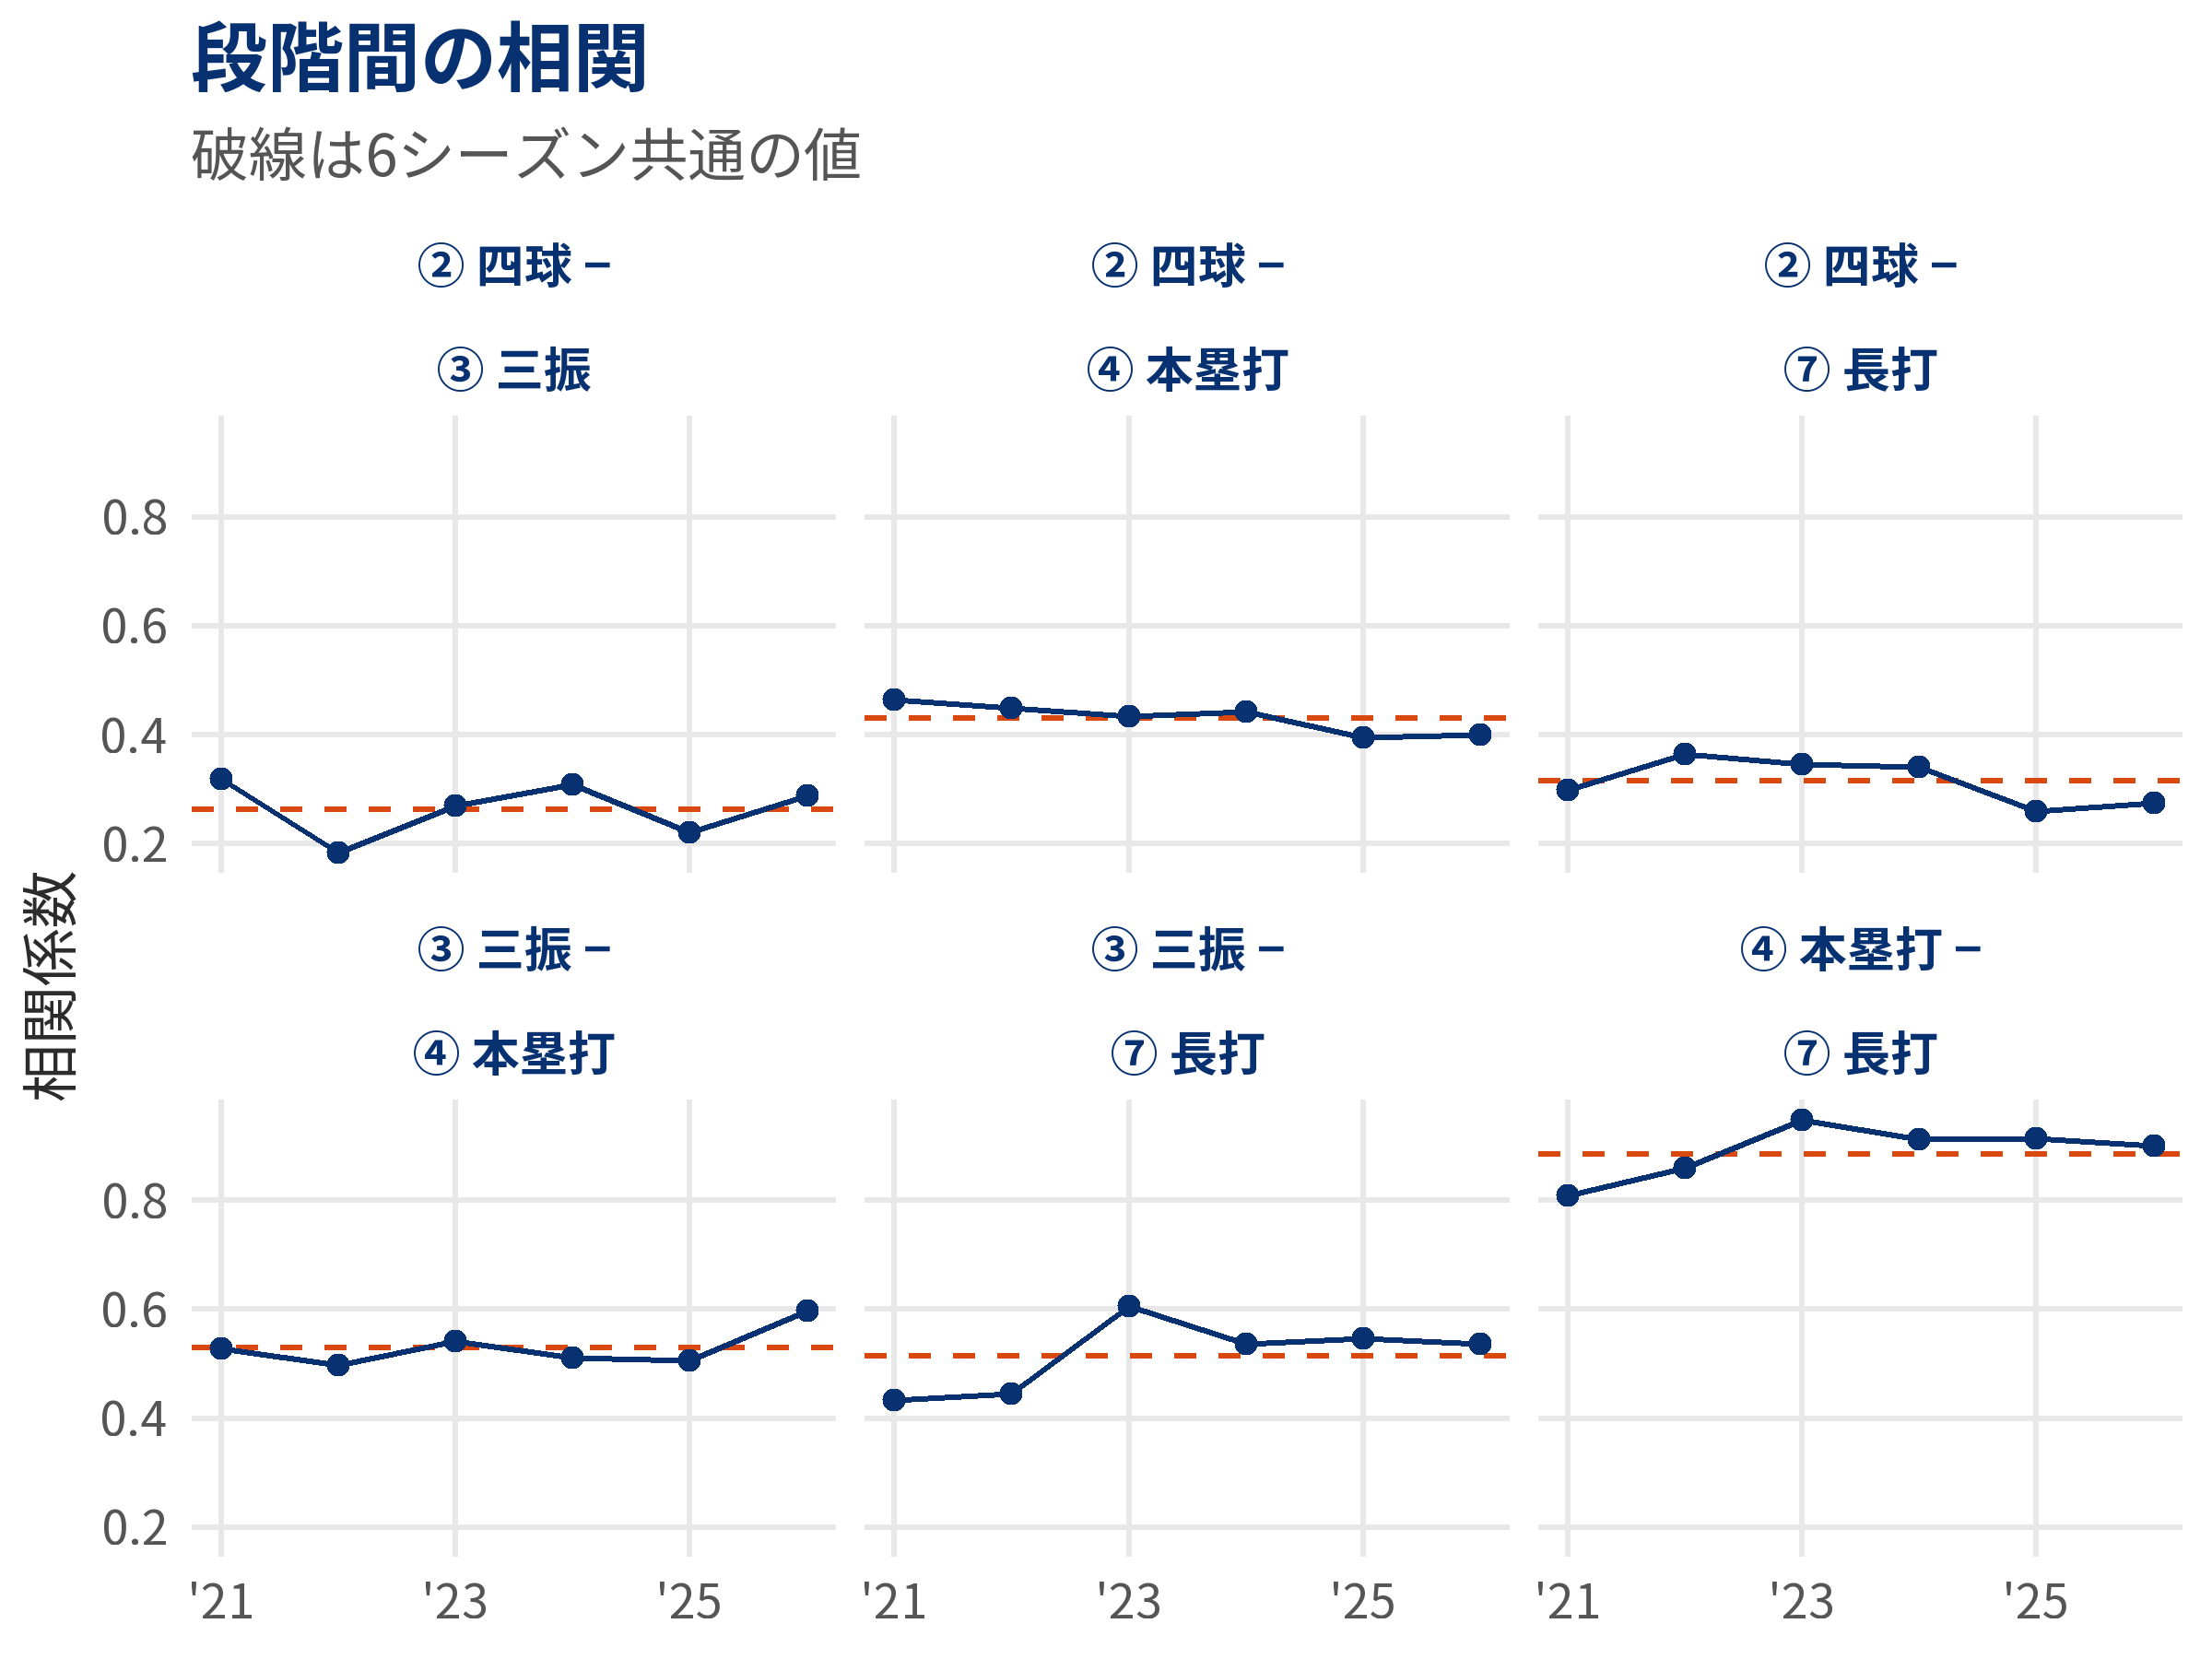
イベント間の相関
傾きが低い原因としてまず思いつくのは、段階を独立に推定していることです。暫定版の打者の推定値どうしの相関を見ると、以下のようになっていました。
| 相関係数 | |
|---|---|
| ③ 三振 / 四死球以外の打席 − ④ 本塁打 / BBE | 0.54 |
| ④ 本塁打 / BBE − ⑦ 長打(二塁打・三塁打) / 安打(BIP) | 0.38 |
| ② 四球 / 死球以外の打席 − ④ 本塁打 / BBE | 0.37 |
| ③ 三振 / 四死球以外の打席 − ⑦ 長打(二塁打・三塁打) / 安打(BIP) | 0.31 |
| ② 四球 / 死球以外の打席 − ③ 三振 / 四死球以外の打席 | 0.30 |
死球、失策出塁、BIP 安打、三塁打は、他とほぼ無相関でした。
この相関は以下の点で利点があるはずです。
情報を利用できる
母集団の情報に加えて、当人の他の段階での情報を利用できます。例えば本塁打の段階において、三振も四球もほとんどしないアラエスが本塁打を量産する可能性は、他の打者より低くなるという傾向を取り入れられます。独立に推定するとアラエスの本塁打確率は 1.2% でしたが、これにより実際(0.6%)により近い 0.75% になりました。
総合的な散らばり方が正しくなる
例えば、本塁打の多い打者は三振も多いので、得点価値では打ち消し合う方向になります。独立に推定すると、この打ち消し合いが反映されず、結果総合的な得点価値での幅が広く残ります。暫定版では、相関を使うと 300 打席以上の打者の標準偏差が 16.8 から 15.7 に縮みました。
セイバーメトリクスではこの手の手法は取られていない印象ですが、特に予測的な文脈では利用価値が高いように思えます。
推定の仕方
モデルは分けたままにしたいので、段階ごとに推定したあとで、相関を使って縮小し直す 2 段階の手法を取ります。各段階の事後分布から、縮小前の値と精度(precision)を逆算して、段階間の相関を算出、まとめての縮小をやり直すという段取りです。
相関を使う段階は、8 段階すべてにすると相関が安定しなかったので、四球・三振・本塁打・長打の 4 段階に絞りました。これによって分割での予測は最も改善し、傾きは 0.63 から 0.76 に上がりました。
最終的なモデルでは、相関は 6 シーズンをまとめて推定した共通の値を使います。「母集団の情報は複数のシーズンから得る」の一例でもあります。
少なくともこの 6 シーズンにおいては凡そ安定していると言えそうです。
打席数の扱い
ここは、最終的に判断を覆した箇所です。
打席数と打力水準
傾きが低い原因として、はっきりした偏りが出たのは打席数でした。推定に使った半分の打席数で分けると、次のようになります(打席あたりの得点価値)。
| 打席数(半分) | もう半分の得点価値 | 予測 |
|---|---|---|
| 50 未満 | −0.049 | −0.012 |
| 50〜150 | −0.023 | −0.012 |
| 150〜250 | −0.008 | −0.008 |
| 250 以上 | +0.013 | +0.004 |
見てわかるように、打席数の少ない打者を高く見積もりすぎ、レギュラーを低く見積もりすぎていました。縮小は「全打者の平均」に向かいますが、打席数の多い打者の方が少ない打者より、集団としての平均の水準が高いことは想像に難くありません。
そこで、打席数(の対数)を、打者の属性を表す固定効果として入れてみました。縮小先が「全打者の平均」から「同程度の打席数の打者の平均」に変わります。
| 入れない | 入れる | |
|---|---|---|
| 誤差 | 0.0334 | 0.0318 |
| 相関 | 0.347 | 0.396 |
| 傾き | 0.70 | 0.83 |
誤差、相関、傾きが改善し、打席数の区分ごとの偏りもほぼ消えました。
ただ、打席数は本人以外の要因によっても変動する数字です。そこでレギュラー層での差はつけない程度の上限は設定しました。単純に規定打席数としても良かったのですが、それなりの合理性も欲しかったので、「球団数 × 9 の枠に入る打席数上位の打者の平均打席数」としました。ユニバーサル DH ではない 2021 年は野手の打席の割合で調整しています。結果としては、毎年 500 前後ではありますので、規定打席くらいが上限という認識で問題ないです。
翌年の成績との関係
同年の分割の結果から、一度は打席数を入れた版を主指標に決めましたが、指標完成後の検証での翌年の成績との関係では打席数を入れない版の方が良いという結果になりました。
この理由は、打席の少ない打者を 2 つに分けると見えてきます。
| 翌年の wRC+ との差(翌年 − 指標) | |||||
| 正なら過小評価 | |||||
| グループ | n | wRC+ | DRC+ (BP) | 自作 DRC+ | 自作(打席数あり) |
|---|---|---|---|---|---|
| 前年300打席以上 | 1333 | −6.7 | −3.5 | −3.5 | −5.7 |
| 300打席未満 → 翌年は300打席以上 | 320 | 11.5 | 9.5 | 8.9 | 17.6 |
| 300打席未満 → 翌年も300打席未満 | 969 | −3.8 | −14.2 | −14.8 | −3.5 |
翌年に打席が増えた打者(故障明けの主力や若手)を、打席数を入れた版は 17 ほど低く見積もっており、翌年も打席が少なかった打者(控え)を、打席数を入れない版は 15 ほど高く見積もっていました。
判断が難しいのは、これは片方が間違っているわけではないという点です。レギュラー水準の打力はある故障者を過小評価しないためには、打席数の補正は邪魔になり、控えを過大評価しないためには、打席数の補正が必要になります。このトレードオフには打席数の補正を入れることを考えた時点で気づいていましたが、同年で検証を実行したことで、打席数の多い打者(翌年 300 打席以上の打者)にバイアスが大きく残る重みを見誤っていました。
ちなみに、打席数を入れた版では、最上位の打者はむしろ少し低くなります(2024 年のジャッジは 189、入れない版は 192)。打席数を入れると、縮小先の水準は上がりますが、打者間の差の一部が打席数で説明される分、縮小そのものが強くなります。
結局、主指標は打席数を入れない版とし、リーダーボードに並べるとしても打席数を入れた版は参考の列とすることにしました。主指標には「控えの打者をやや高く見積もる」という性質が残ることは留意点です。
Statcast データの利用
先に述べたように、打球が発生する段階での精度向上のため、Statcast データを利用します。
Statcast データの位置づけ
Statcast データは打者本人に帰属させるため、説明変数ではなく、結果(0 か 1 か)の代わりの観測値として使います。
使うのは、結果が打球の性質でおおむね決まり、件数も多い ④本塁打・⑥安打・⑦長打 の 3 段階です。⑤失策出塁と ⑧三塁打は、守備や走塁の影響が大きく件数も少ないので、結果をそのまま使います。
手順は以下です。
打球単位のモデル
打球の性質と環境から、対象のイベントになる確率を出します。
中立化
その打球を全球場・全条件に置いて、確率を平均します。球場補正は、ここで打球ごとに行われます。
モデルへの組み込み
中立化した確率を、0/1 の結果の代わりに目的変数として、これまでと同じ階層モデルを推定します。球場と気温はすでに調整済みなので外します。
確率を目的変数にすると、0/1 の結果より 1 件あたりの情報が多くなります。この情報量の比を尤度の重みとして掛けています(安打の段階で約 2.6、長打の段階で約 1.6)。
本塁打モデル
対象は、打球速度 90mph 以上・垂直角度 10〜50 度・水平角度 ±50 度以内の打球です。これ以外の打球が本塁打になることはほとんどないので(2024 年で 47 本)実際の結果をそのまま使います。
打球の水平角度には 2 つの捉え方があるので、別々に入れます。打者基準の水平角度(引っ張りか流しか)は打球の伸び方を、球場基準の水平角度(レフト方向かライト方向か)は、球場ごとのフェンスまでの距離と高さ、その球場で一貫した風の影響を表します。
| モデル | 対数損失 |
|---|---|
| 速度と垂直角度のみ | 0.201 |
| + 打者基準の水平角度 | 0.141 |
| + 球場 × 打席左右 | 0.141 から −0.0030 |
| + 球場 × 球場基準の水平角度 | 0.141 から −0.0146 |
水平角度を入れるだけで 3 割改善します。また、Baseball Prospectus が使っていた「球場 × 打席左右」に比べて、球場ごとの打球方向による違いを入れると、改善は 5 倍になりました。
気温の効果は、打球の質をそろえると、打者単位のモデルで推定していた値の約 3 倍になりました。
ボールの飛びやすさは年によって違いますが、打球単位のモデルはシーズンごとに推定しているので、その年の飛びやすさは自動で織り込まれます。
各打球を全球場に置いて平均すると、球場ごとの本塁打の出やすさが、打球の質をそろえた形で分かります。
ノート球場×打席ごとの本塁打の出やすさ
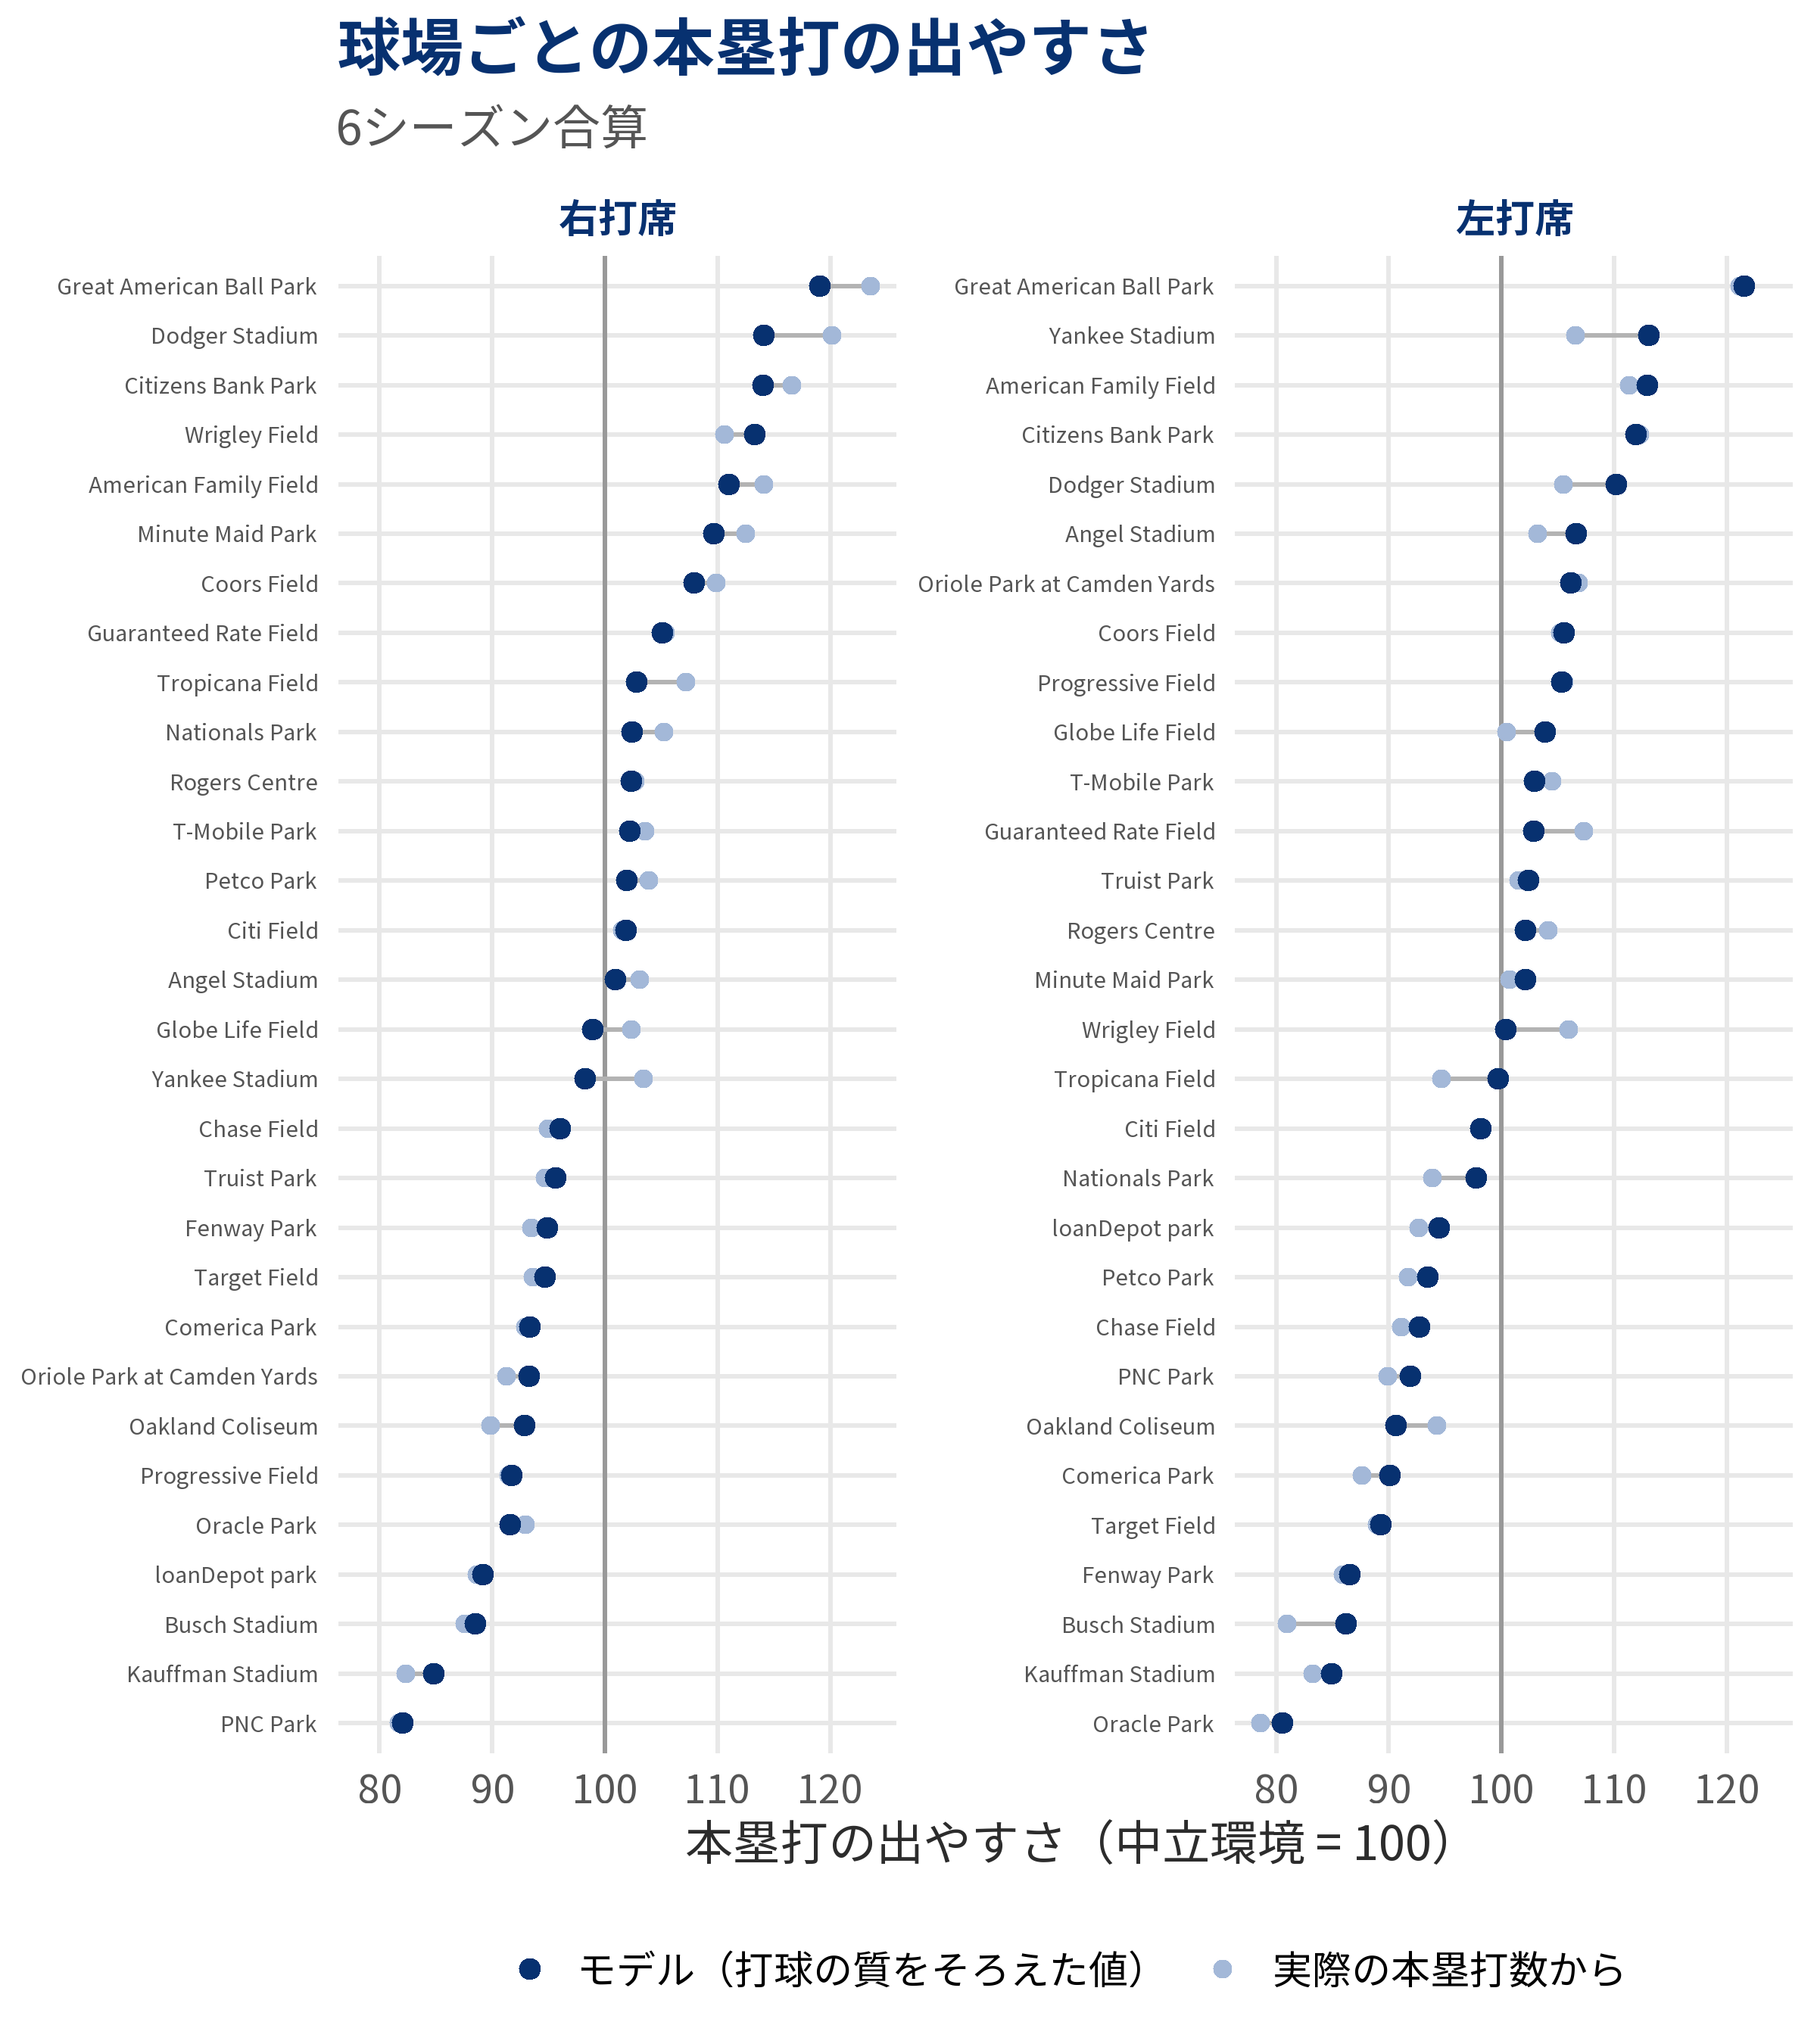
実際の本塁打数から計算した PF は 1 シーズンではかなり暴れます。たとえば 2024 年のペトコ・パークの右打者は、実際の本塁打数から算出した PF では 135 でしたが、打球の質をそろえると 111 でした。
Baseball Prospectus は、年によって球場環境が変わることから、複数年の PF に否定的でしたが、個人的には Statcast データを使うことが前提となるものと思います。
以下は 2024 年において、中立環境から期待される本塁打数の上位の打者の内訳です。
| 本塁打の内訳(2024年) | |||||
| 打球速度・垂直角度・水平角度から出した本塁打数。補正係数を掛ける前の値。 | |||||
| 打者 | 実際 | 実際の環境での期待 | 中立環境での期待 | 環境の恩恵 | 期待との差 |
|---|---|---|---|---|---|
| Judge, Aaron | 58 | 64.3 | 61.5 | 2.8 | −6.3 |
| Ohtani, Shohei | 54 | 61.7 | 60.0 | 1.7 | −7.7 |
| Soto, Juan | 41 | 51.3 | 50.1 | 1.2 | −10.3 |
| Ozuna, Marcell | 39 | 41.7 | 44.4 | −2.7 | −2.7 |
| Rooker, Brent | 39 | 40.5 | 40.1 | 0.4 | −1.5 |
| Witt Jr., Bobby | 32 | 34.9 | 39.0 | −4.1 | −2.9 |
| Schwarber, Kyle | 38 | 40.6 | 38.7 | 1.9 | −2.6 |
| Alvarez, Yordan | 35 | 37.5 | 38.2 | −0.7 | −2.5 |
| Raleigh, Cal | 34 | 37.4 | 37.2 | 0.1 | −3.4 |
| Lindor, Francisco | 33 | 36.5 | 35.7 | 0.8 | −3.5 |
| Santander, Anthony | 44 | 35.1 | 34.7 | 0.4 | 8.9 |
| Perez, Salvador | 27 | 30.8 | 34.4 | −3.7 | −3.8 |
上位層では全体的に、中立環境での期待値やそれに伴う実際の環境での期待値が実際のそれより高くなり、Baseball Savant の xHR と見比べてみても違和感はあります。
同年の分割で検証すると、Statcast データを使った版は相関は上がったものの傾きが下がりました。
| モデル | 相関 | 傾き |
|---|---|---|
| 結果だけの階層モデル | 0.581 | 0.95 |
| Statcast データを使った階層モデル | 0.626 | 0.84 |
| Statcast データ + 補正係数 | 0.63 | 0.92 |
傾き 0.84 は、打者間の差を 2 割近く広く見積もっていることを意味します。これは先ほど触れた、本塁打上位層での期待値の上方へのズレともつながります。原因をいくつか調べましたが特定はできず、補正係数を入れることにしました。
ノート調べた原因
情報の漏れ
打球単位のモデルを、評価する打球自身も使って学習していたので、その影響を疑いました。試合単位の交差検証に変え、どの打球の確率も「その打球を学習に使っていないモデル」から出すようにしましたが、傾きは 0.84 のままでした(交差検証はそのまま本番でも使っています)。
打者に固有のズレ
同じ打球でも本塁打になりやすい打者がいるなら、打球の質だけでは足りません。しかし、「実際の本塁打数と期待値の差」は分割したデータ間で持続しませんでした(相関 0.07)。
バットトラッキングデータ
2023 年の途中から取れるバットトラッキングデータを試しました。オフセットから打球の回転の質を探るため、Attack Angle と打球角度のズレを入れると、打球単位の予測は約 3% 改善しましたが、打者単位ではほとんど残りました。同じく回転の質を探るため Squared-up Rate も試しましたが、予測は改善しませんでした。6 シーズン通しては使えないデータなので、採用していません。
打者ごとに、打球の質から出した本塁打の確率と実際の割合を比べると、打球の質で 1 違う打者は、実際には 0.9 ほどしか違いませんでした(分割の 2 通りで 0.90 と 0.93)。この割合を補正係数として、打者間の差を割り引きます。これにより傾きは 0.84 から 0.92 に改善しました。
安打モデル / 長打モデル
同じ方法を、「⑥ 安打 / 失策以外の BIP」と「⑦ 長打 / 安打(BIP)」の段階にも使いました。こちらは打球の性質だけでは決まらないので、走力と守備を加えています。走力は予測がわずかに改善した一塁到達タイム(その年の平均)にしました。
分割での結果です。
| 段階 | モデル | 誤差 | 相関 | 傾き |
|---|---|---|---|---|
| ⑥ 安打 | 結果だけ | 0.0391 | 0.212 | 0.93 |
| Statcast データ | 0.0381 | 0.282 | 0.96 | |
| ⑦ 長打 | 結果だけ | 0.0615 | 0.235 | |
| Statcast データ | 0.0605 | 0.290 | 0.83 | |
| Statcast データ + 補正係数 | 0.0603 | 0.295 | 0.97 |
安打の段階は、結果だけではほとんど平均に縮小されていましたが、これにより打者間の差が残るようになります。長打は本塁打と同じく補正係数を入れています。
最終仕様
ここまでの判断をまとめた、最終的な仕様です。
| 段階 | 使うデータ | 固定効果 | ランダム効果 | 打者の分布 |
|---|---|---|---|---|
| ① 死球 / 全打席 | 結果 | 共通 | 打者、投手 | 正規 |
| ② 四球 / 死球以外の打席 | 結果 | 共通、気温 | 打者、投手、球場 | 正規 |
| ③ 三振 / 四死球以外の打席 | 結果 | 共通、気温 | 打者、投手、球場 | t(自由度 12) |
| ④ 本塁打 / BBE | Statcast | 共通 | 打者、投手 | 正規 |
| ⑤ 失策出塁 / BIP | 結果 | 共通 | 打者、投手、守備側チーム、球場 | 正規 |
| ⑥ アウト / 失策以外の BIP | Statcast | 共通 | 打者、投手 | 正規 |
| ⑦ 単打 / 安打 | Statcast | 共通 | 打者、投手 | 正規 |
| ⑧ 三塁打 / 二塁打・三塁打 | 結果 | 共通 | 打者、投手、守備側チーム、球場 × 打席左右 | 正規 |
「共通」の固定効果は、左打席、プラトーン、野手登板、(2021 年のみ)投手の打席です。Statcast データを使う段階の球場・気温・守備は、打球単位のモデルの側で調整しています。
球場はランダム効果にしています。主要な球場は年に約 6,000 打席あるので縮小は小さく、数試合しか使われない球場(海外開催など)は自動で強く縮小されます。
各段階のモデル
各段階は、次の形のロジスティック回帰です。
\text{logit}\, p = \alpha + \mathbf{x}^\top \boldsymbol\beta + \sigma_{\text{打者}} z_{\text{打者}} + \sigma_{\text{投手}} z_{\text{投手}} + \cdots
\mathbf{x} は固定効果、z はランダム効果です。事前分布は \alpha \sim N(0, 1.5)、\beta \sim N(0, 1)、\sigma \sim N^+(0, 1) と、弱いものを置いています。推定を極端な値から守りながらも、データ量が多いので、結果はほぼデータで決まります。
Stan のコードは、8 段階で共通です。段階ごとに変わるのは、どの固定効果とランダム効果を入れるかだけで、これはデータとして渡しています(Statcast データを使う段階だけ、尤度を変えたもう 1 つを使います)。
推定結果
6 シーズン × 2 つの版(打席数あり・なし)× 8 段階で、96 個のモデルを推定しました。全体では 26 時間ほどかかっています。PC 環境によっては 2 ~ 3 倍かかる可能性もありますので、モデルを固める前の単シーズンでの検証やモデル分割の重要性が分かるかと思います。
打者効果の標準偏差・ランダム効果の標準偏差・固定効果の係数・Statcast データを使う段階での補正係数・打席数あり版での打席数の係数に興味があれば以下にまとめています。
ノート推定結果まとめ
| 打者の効果の標準偏差 | ||||||
| ロジットの単位。大きいほど、その段階で差がつきやすい | ||||||
| 段階 | 2021 | 2022 | 2023 | 2024 | 2025 | 2026 |
|---|---|---|---|---|---|---|
| ① 死球 / 全打席 | 0.62 | 0.51 | 0.61 | 0.58 | 0.57 | 0.59 |
| ② 四球 / 死球以外の打席 | 0.32 | 0.33 | 0.33 | 0.31 | 0.32 | 0.33 |
| ③ 三振 / 四死球以外の打席 | 0.38 | 0.38 | 0.35 | 0.35 | 0.36 | 0.36 |
| ④ 本塁打 / BBE | 0.57 | 0.55 | 0.55 | 0.53 | 0.54 | 0.52 |
| ⑤ 失策出塁 / BIP | 0.15 | 0.23 | 0.10 | 0.11 | 0.18 | 0.08 |
| ⑥ 安打 / 失策以外の BIP | 0.11 | 0.10 | 0.11 | 0.09 | 0.08 | 0.10 |
| ⑦ 長打 / 安打 | 0.23 | 0.24 | 0.20 | 0.22 | 0.21 | 0.22 |
| ⑧ 三塁打 / 二塁打・三塁打 | 0.44 | 0.52 | 0.60 | 0.61 | 0.63 | 0.53 |
| ランダム効果の標準偏差(6シーズンの平均) | |||||
| ロジットの単位。空欄はその段階に入れていない効果 | |||||
| 段階 | 打者 | 投手 | 球場 | 守備チーム | 球場×打席左右 |
|---|---|---|---|---|---|
| ① 死球 / 全打席 | 0.58 | 0.46 | |||
| ② 四球 / 死球以外の打席 | 0.32 | 0.29 | 0.04 | ||
| ③ 三振 / 四死球以外の打席 | 0.36 | 0.30 | 0.08 | ||
| ④ 本塁打 / BBE | 0.54 | 0.19 | |||
| ⑤ 失策出塁 / BIP | 0.14 | 0.14 | 0.09 | 0.14 | |
| ⑥ 安打 / 失策以外の BIP | 0.10 | 0.05 | |||
| ⑦ 長打 / 安打 | 0.22 | 0.11 | |||
| ⑧ 三塁打 / 二塁打・三塁打 | 0.56 | 0.20 | 0.12 | 0.31 | |
| 固定効果の係数(6シーズンの平均) | |||||
| ロジットの単位。投手の打席は2021年のみ | |||||
| 段階 | 左打席 | 同プラトーン | 野手登板 | 投手の打席 | 気温 |
|---|---|---|---|---|---|
| ① 死球 / 全打席 | 0.03 | 0.36 | 0.56 | −1.09 | |
| ② 四球 / 死球以外の打席 | 0.11 | −0.18 | −0.09 | −0.72 | −0.03 |
| ③ 三振 / 四死球以外の打席 | 0.07 | 0.09 | −2.44 | 1.21 | −0.02 |
| ④ 本塁打 / BBE | −0.05 | −0.25 | 0.46 | −1.92 | |
| ⑤ 失策出塁 / BIP | −0.32 | 0.00 | −0.14 | −0.21 | |
| ⑥ 安打 / 失策以外の BIP | −0.07 | −0.04 | 0.13 | −0.12 | |
| ⑦ 長打 / 安打 | 0.01 | −0.18 | 0.29 | −0.31 | |
| ⑧ 三塁打 / 二塁打・三塁打 | 0.51 | 0.03 | −0.66 | −1.24 | |
| 補正係数(傾き) | ||||||
| 1未満は、打球の質から出した差が実際の結果より広がりすぎていることを示す | ||||||
| 段階 | 2021 | 2022 | 2023 | 2024 | 2025 | 2026 |
|---|---|---|---|---|---|---|
| ④ 本塁打 / BBE | 0.93 | 0.96 | 0.96 | 0.91 | 0.97 | 0.92 |
| ⑥ 安打 / 失策以外の BIP | 1.09 | 1.08 | 0.99 | 1.01 | 1.06 | 1.06 |
| ⑦ 長打 / 安打 | 0.79 | 0.80 | 0.79 | 0.85 | 0.81 | 0.80 |
| 打席数(対数・上限つき)の係数 | ||||||
| 打席数を入れた版 | ||||||
| 段階 | 2021 | 2022 | 2023 | 2024 | 2025 | 2026 |
|---|---|---|---|---|---|---|
| ① 死球 / 全打席 | −0.02 | 0.01 | 0.02 | 0.04 | −0.05 | 0.02 |
| ② 四球 / 死球以外の打席 | 0.09 | 0.06 | 0.06 | 0.06 | 0.09 | 0.12 |
| ③ 三振 / 四死球以外の打席 | −0.19 | −0.21 | −0.17 | −0.17 | −0.18 | −0.18 |
| ④ 本塁打 / BBE | 0.27 | 0.24 | 0.25 | 0.24 | 0.22 | 0.24 |
| ⑤ 失策出塁 / BIP | −0.02 | −0.08 | −0.02 | −0.06 | −0.15 | 0.03 |
| ⑥ 安打 / 失策以外の BIP | 0.08 | 0.05 | 0.06 | 0.04 | 0.06 | 0.06 |
| ⑦ 長打 / 安打 | 0.05 | 0.10 | 0.10 | 0.07 | 0.06 | 0.07 |
| ⑧ 三塁打 / 二塁打・三塁打 | −0.11 | −0.12 | 0.01 | −0.01 | 0.00 | −0.04 |
段階ごとの打者効果の標準偏差は年をまたいで安定しています。補正係数は、本塁打が 0.91〜0.97、長打が 0.79〜0.85 と、毎年 1 を下回りました。2024 年の分割での特徴は共通する性質でした。
DRC+ を算出する
後処理の流れ
段階ごとの推定が終わったら、次の順に DRC+ を算出します。
- 各段階の事後分布からサンプルを取り出します(400 個)。
- 四球・三振・本塁打・長打の打者の効果を、6 シーズン共通の相関で縮小し直します。
- Statcast データを使う段階に、補正係数を掛けます。
- 中立環境(リーグの実際の打席 3,000 個)で、9 カテゴリの確率を計算します。
- 得点価値を掛け、価値の補正(次の節)を加え、リーグ平均が 100 になるように調整します。
ノート得点価値
| 得点価値 | ||||||
| 平均的な得点期待値の変動 | ||||||
| イベント | 2021 | 2022 | 2023 | 2024 | 2025 | 2026 |
|---|---|---|---|---|---|---|
| 死球 | 0.358 | 0.354 | 0.356 | 0.353 | 0.347 | 0.352 |
| 四球 | 0.336 | 0.329 | 0.332 | 0.330 | 0.333 | 0.336 |
| 三振 | −0.268 | −0.266 | −0.269 | −0.267 | −0.269 | −0.270 |
| 本塁打 | 1.387 | 1.398 | 1.383 | 1.400 | 1.382 | 1.393 |
| 失策出塁 | 0.436 | 0.437 | 0.444 | 0.443 | 0.438 | 0.445 |
| 単打 | 0.466 | 0.458 | 0.470 | 0.464 | 0.464 | 0.470 |
| 二塁打 | 0.760 | 0.765 | 0.765 | 0.754 | 0.763 | 0.759 |
| 三塁打 | 1.044 | 1.028 | 1.056 | 1.026 | 1.040 | 1.054 |
| インプレーアウト | −0.266 | −0.266 | −0.268 | −0.263 | −0.263 | −0.265 |
| (R/PA) | 0.121 | 0.114 | 0.122 | 0.117 | 0.118 | 0.118 |
イベントごとに、実際の確率と推定した確率を比べると、縮小の強さの違いが見えます。
| カテゴリごとの縮小の強さ | ||||||
| 300打席以上。幅の比が小さいほど強く縮めている(率は%) | ||||||
| イベント | 実際の率の平均 | 推定の平均 | 実際の率の標準偏差 | 推定の標準偏差 | 幅の比 | 相関 |
|---|---|---|---|---|---|---|
| 死球 | 1.13 | 1.14 | 0.84 | 0.57 | 0.68 | 0.99 |
| 四球 | 8.35 | 8.31 | 2.80 | 2.27 | 0.81 | 0.99 |
| 三振 | 21.85 | 22.15 | 5.87 | 5.45 | 0.93 | 0.99 |
| 本塁打 | 3.23 | 3.12 | 1.50 | 1.21 | 0.80 | 0.92 |
| 失策出塁 | 0.60 | 0.61 | 0.39 | 0.13 | 0.32 | 0.50 |
| 単打 | 14.52 | 14.35 | 2.79 | 2.25 | 0.81 | 0.85 |
| 二塁打 | 4.43 | 4.37 | 1.07 | 0.45 | 0.42 | 0.63 |
| 三塁打 | 0.38 | 0.37 | 0.38 | 0.15 | 0.39 | 0.88 |
| インプレーアウト | 45.50 | 45.58 | 5.83 | 5.04 | 0.86 | 0.96 |
三振や四球は実際の率に近いまま残り、単打や二塁打、失策出塁は強く平均に寄せられています。これは、Baseball Prospectus の DRC+ でも同じはずです。
不確実性
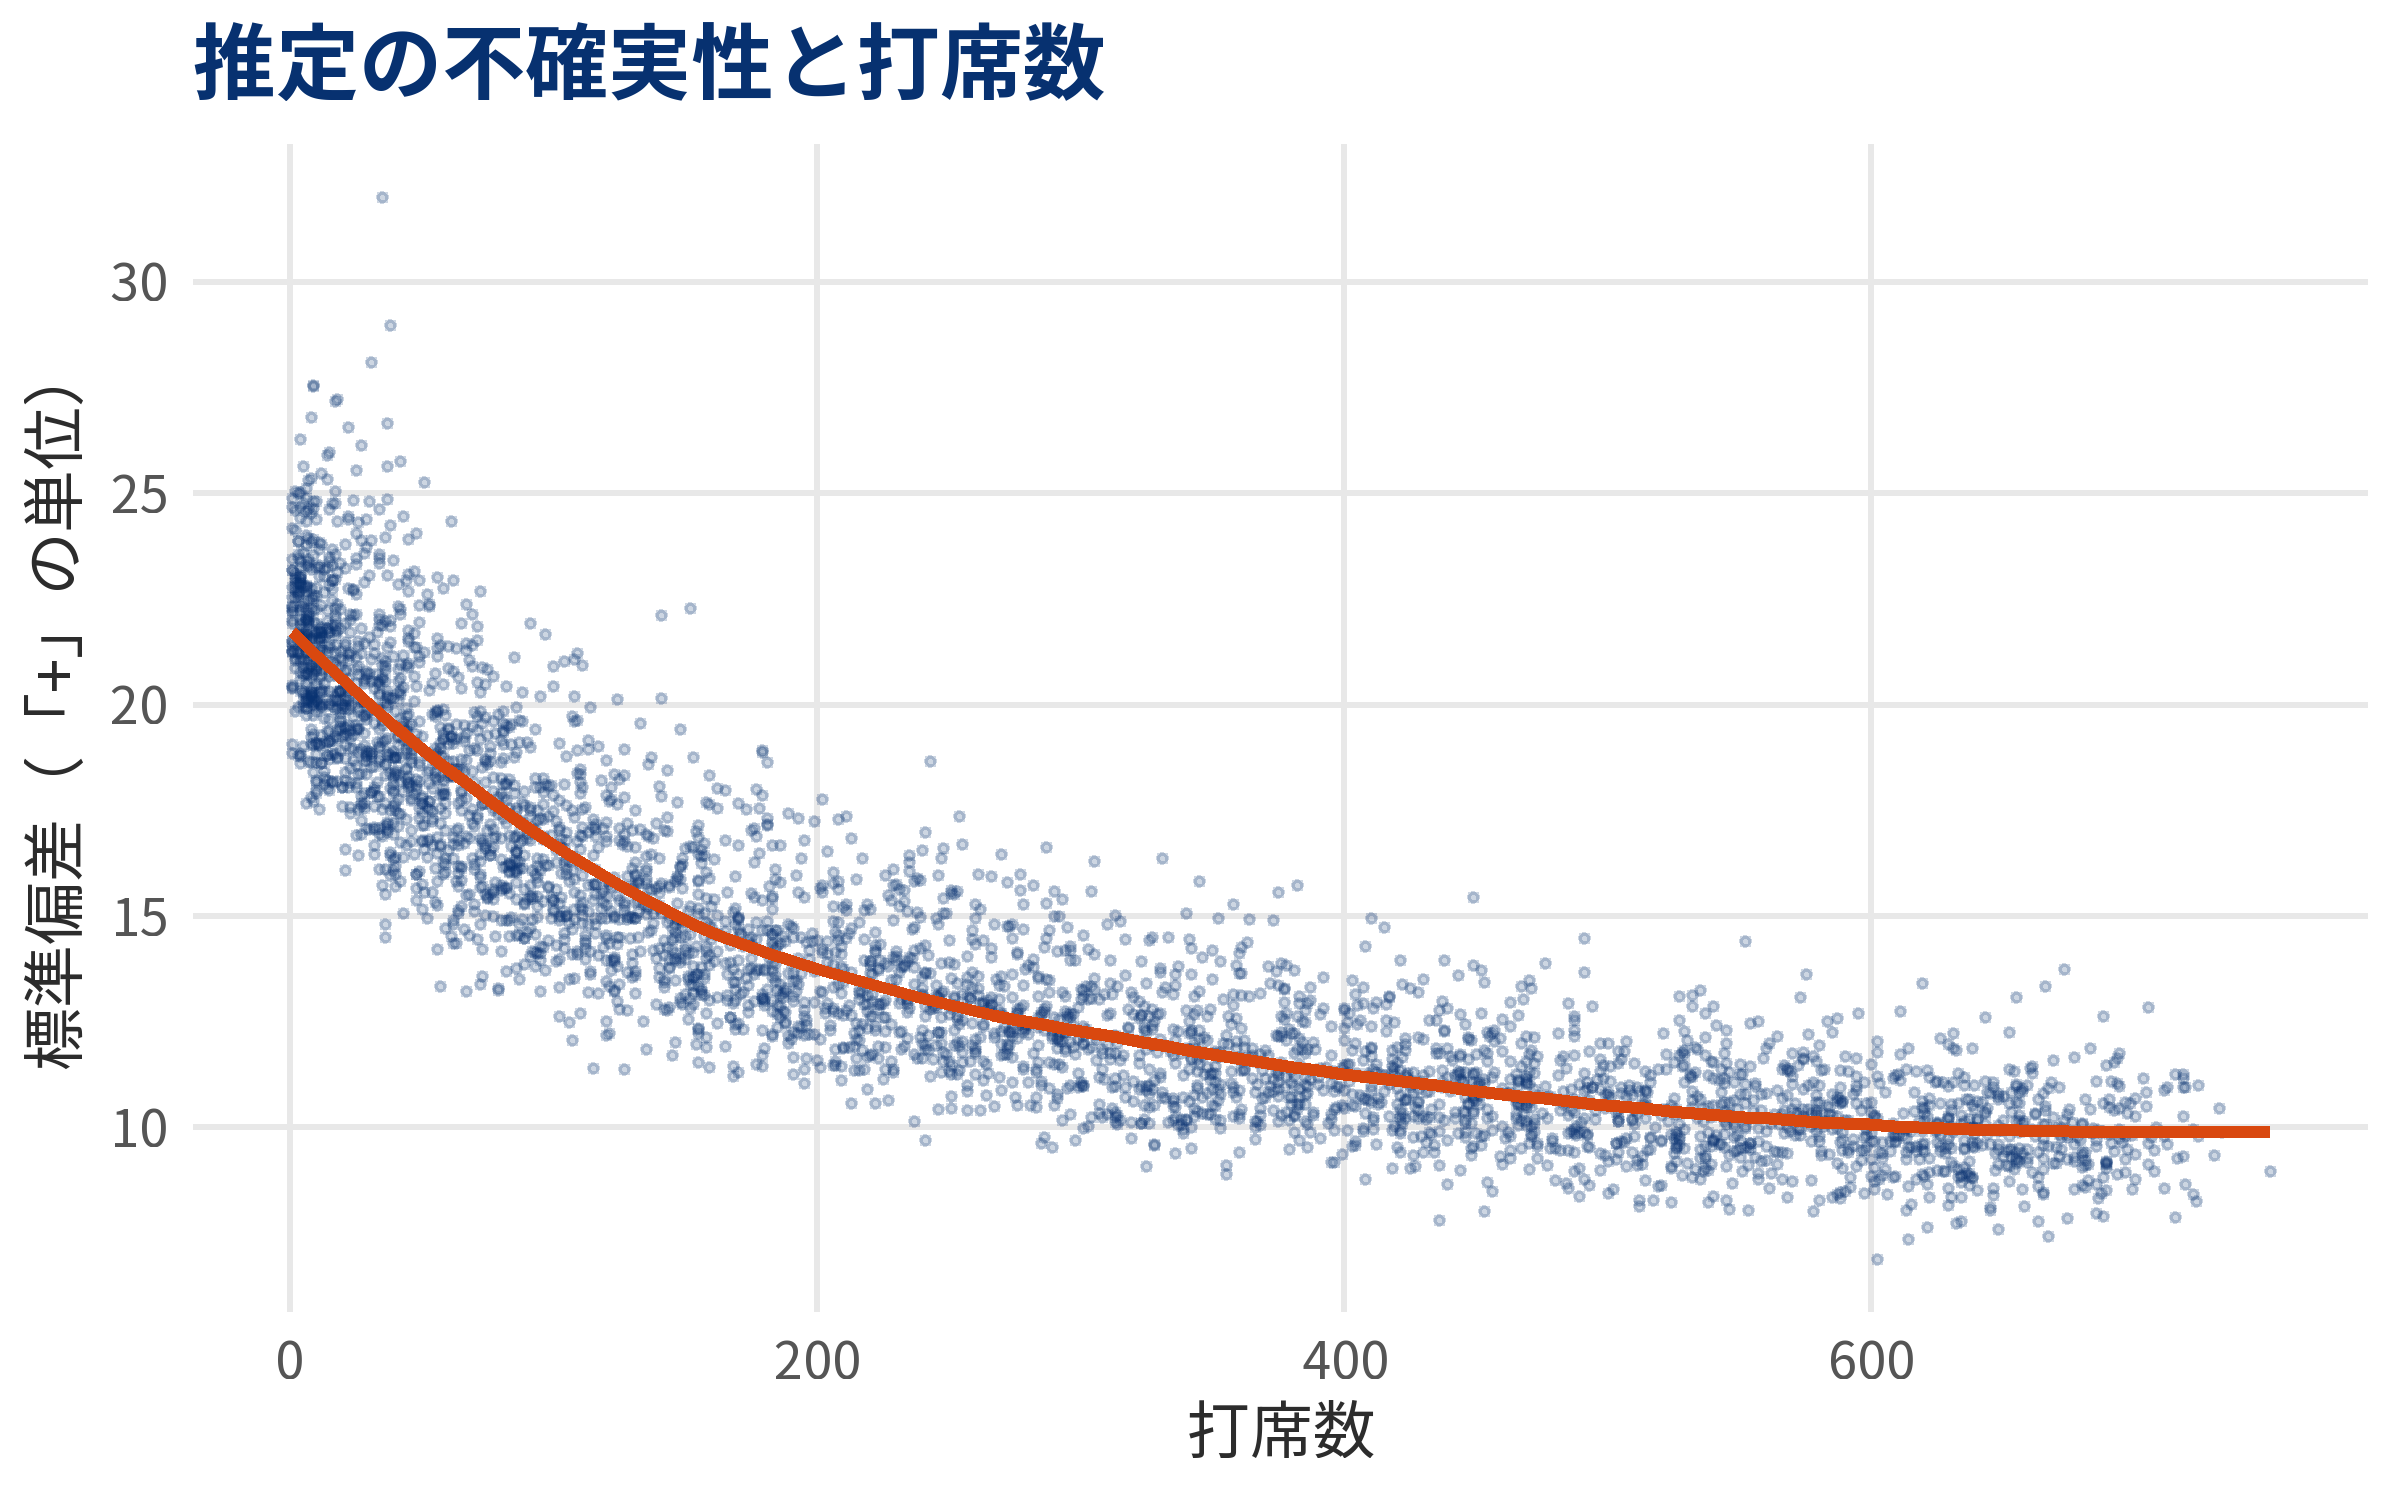
サンプルごとに 1〜5 を計算するので、指標の値もサンプルの数だけ得られます。その標準偏差と 90% 区間を、推定の不確実性としました。
含めているのは、打者の効果、相関で縮小し直したあと、補正係数、価値の補正のそれぞれの標準誤差です。
打球単位のモデルの誤差、得点価値の誤差、相関行列の誤差は含めず、それぞれ固定した値として扱っています。当然、モデルの形そのものが正しいかどうかの不確実性も含まれません。区間の幅が適切かどうかは、後の検証で確かめます。
ノート打席数と不確実性の関係
| 推定の不確実性 | |||
| 打席数 | 打者数 | 標準偏差の平均 | 90%区間の幅の平均 |
|---|---|---|---|
| 100未満 | 1202 | 19.5 | 63.3 |
| 100〜299 | 1118 | 14.2 | 46.2 |
| 300〜499 | 849 | 11.4 | 37.1 |
| 500以上 | 805 | 10.1 | 33.0 |
得点価値の補正
例えば wOBA では、「アウト」や「単打」には全員同じ得点価値が掛かります。しかし、これらは状況によって変動するのは周知されている通りです。内野安打は平均的な単打より −0.04、併殺は平均的なアウトより −0.38、犠飛は +0.35 などです。
先述したように、Baseball Prospectus では単一アウトと複数アウトの価値の違いを考慮しています。Baseball Reference の rOBA もイベントを細かく区別することでこの問題に対処していることは有名でしょう。
今回、自作版では補正が必要なイベントについて、打者ごとに得点価値補正を加えます。
当初は、併殺を木の段階に組み込むことを考えていました。しかし、打者の貢献として、機会の調整が必要になる以上、それらを含めた補正値をモデルの外で推定する手法がより合理的と考えました。
単純な手法としては、RE24 的に実際に変動した得点価値を見ることですが、察しのとおり、これらはほとんど一貫性はなく、打者の寄与とするのは粗いです。
そこで、ここでも Statcast データを使います。
各打席の得点価値から「同じイベント・同じ塁アウト状況の平均の得点価値」を引いた残差を、Statcast データで説明するモデルを作ります。
- 説明変数:打球速度、垂直角度、水平角度、一塁到達タイム、打席の左右
- 塁アウト状況:5 つのカテゴリ(走者なし/併殺機会(一塁走者あり・2 アウト未満)/三塁走者あり(一塁は空き・2 アウト未満)/二塁走者のみ(2 アウト未満)/走者ありの 2 アウト)に分ける
5 つの塁アウト状況カテゴリのそれぞれで、上記の残差と説明変数の関係を GAM で推定します。その後その 5 つをリーグ全体の割合で重み付けします。これにより、打者が操作できない塁アウト状況の偏りは中立化されます。これらを打者 × イベントごとに平均縮小しています。
以下は 2024 年の分割における実際に変動したイベントあたりの余剰得点価値と上記手法により算出した値の一貫性です。
| 余剰得点価値の一貫性 | |||||
| 2024年を分割 | |||||
| イベント | 打者数 |
分割した A と B の相関
|
予測の標準偏差 | ||
|---|---|---|---|---|---|
| 実際 ↔︎ 実際 | 予測 ↔︎ 予測 | 予測 → 実際 | |||
| インプレーアウト | 204 | 0.11 | 0.89 | 0.33 | 0.005 |
| 単打 | 216 | 0.17 | 0.68 | 0.17 | 0.005 |
| 二塁打 | 118 | 0.25 | 0.81 | 0.08 | 0.010 |
| 実際:同じ走者状況・同じイベントの平均を上回った得点価値(イベントあたり)。 期待:Statcast データから予測した余剰得点価値(走者状況は中立化、縮小前)。 期待 → 実際:片方の半分の予測ともう片方の実際との相関。 | |||||
一塁到達タイムと打席左右という変数が入っているので当たり前ですが、一貫性は実際のそれより Statcast データによる期待余剰得点価値の方が高いです。予測という面でも、単打や二塁打といった打順やチームメイトの走力が大いに関わるイベントには疑いが残りますが、比較的それらの影響が抑えられるインプレーアウトでは予測性も高くなっています。
これらを DRC+ に組み込みます。
対象は、アウト・単打・二塁打の 3 つです。本塁打・三塁打・四球・死球・三振は、打球の性質による価値の違いがないので対象外です。打者ごとの値は、サンプルサイズに応じて 0 に向けて縮小してから、「そのイベントの確率 × 価値の差」として指標に加えます。
以下が補正による DRC+ の変動の分布です。
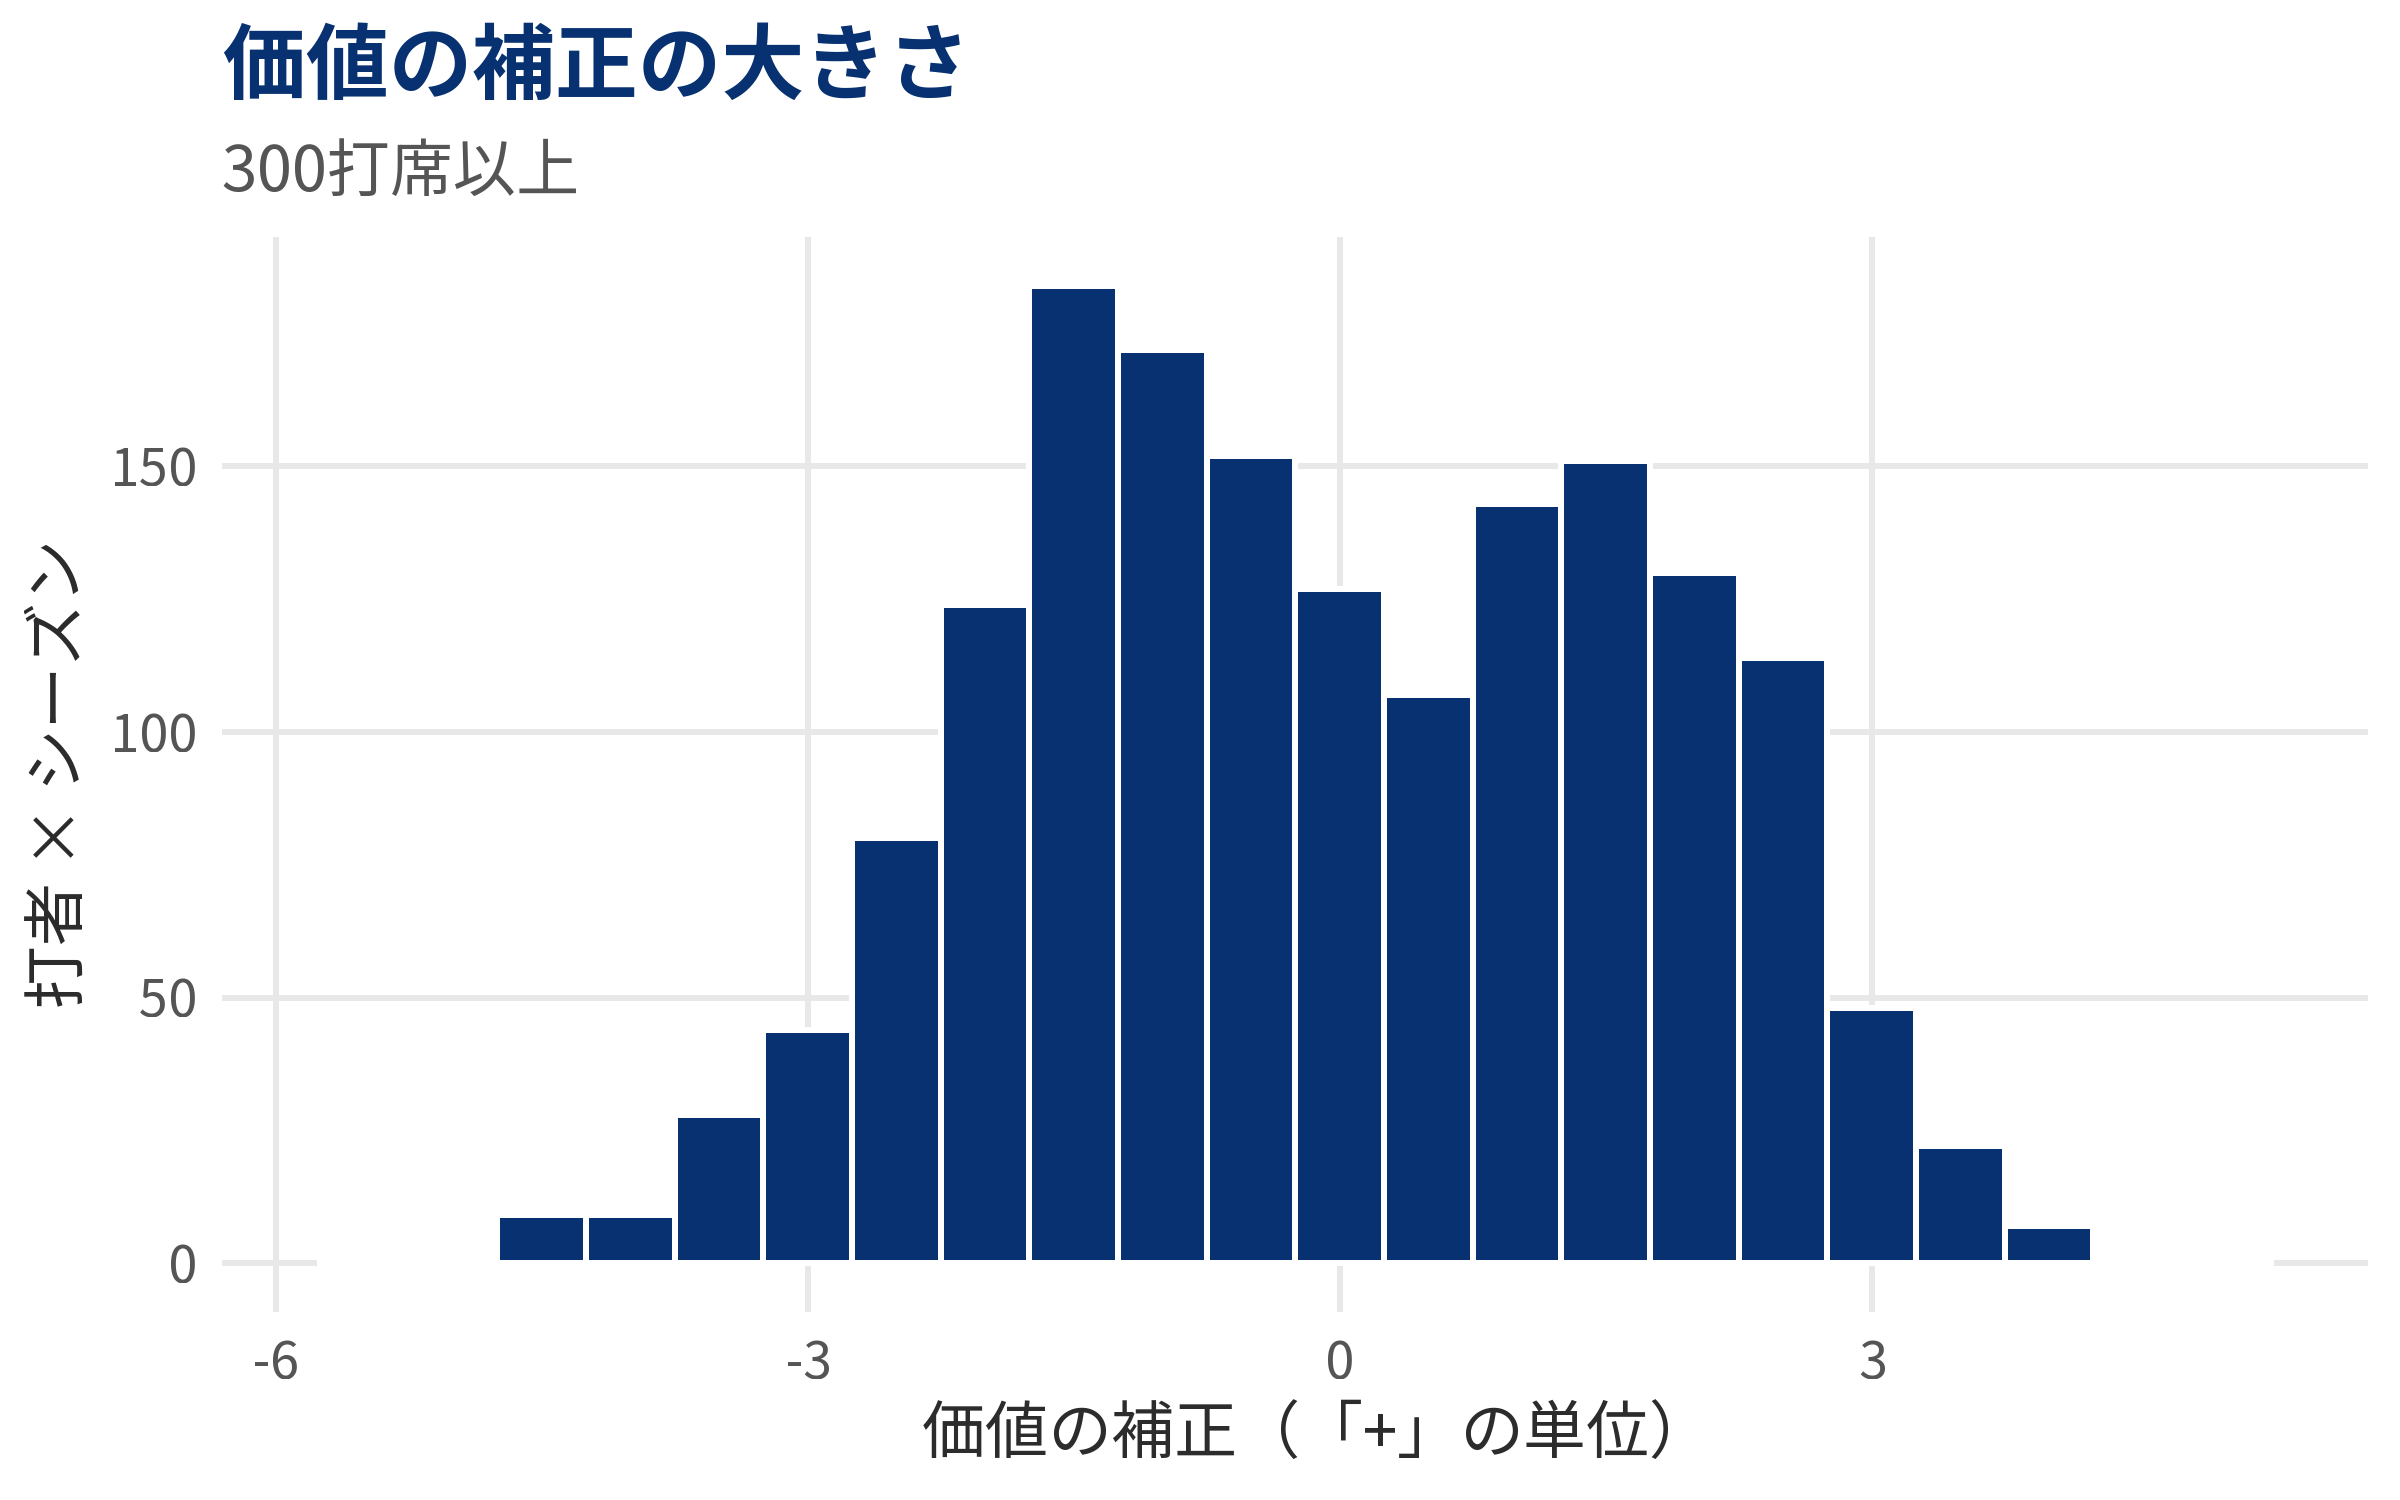
指標への影響は、標準偏差で 1.5〜1.9、最大でも ±5 ほどです。大きくはありませんが、同じタイプの打者が年をまたいで現れます。
| 価値の補正が大きい打者 | |||||
| 300打席以上、上位と下位 | |||||
| シーズン | 打者 | 打席数 | 補正前 | 補正後 | 補正 |
|---|---|---|---|---|---|
| 2024 | Bellinger, Cody | 562 | 98.9 | 103.7 | 4.8 |
| 2025 | Bellinger, Cody | 655 | 110.1 | 114.3 | 4.2 |
| 2022 | Gorman, Nolan | 313 | 102.7 | 106.8 | 4.1 |
| 2024 | Hamilton, David | 317 | 83.8 | 87.8 | 3.9 |
| 2025 | Crow-Armstrong, Pete | 640 | 111.1 | 115.0 | 3.9 |
| 2024 | McKinstry, Zach | 325 | 88.3 | 92.2 | 3.9 |
| 2023 | Bellinger, Cody | 553 | 106.3 | 110.2 | 3.8 |
| 2022 | Polanco, Jorge | 444 | 126.9 | 130.6 | 3.8 |
| 2022 | Pujols, Albert | 350 | 128.6 | 123.3 | −5.4 |
| 2021 | Franco, Maikel | 403 | 67.8 | 63.0 | −4.8 |
| 2024 | Jiménez, Eloy | 348 | 75.2 | 70.5 | −4.6 |
| 2024 | Díaz, Elias | 349 | 80.3 | 75.7 | −4.6 |
| 2024 | Fermin, Freddy | 366 | 84.3 | 79.9 | −4.5 |
| 2024 | Rojas, Miguel | 335 | 97.9 | 93.4 | −4.5 |
| 2026 | Durbin, Caleb | 577 | 97.6 | 93.1 | −4.4 |
| 2026 | Fortes, Nick | 319 | 81.9 | 77.5 | −4.4 |
上位にはベリンジャーのようなフライが多く一塁到達が速い左打者、下位にはプホルスのような足の遅い右打者が並びます。
四球と本塁打の場面の偏りの補正は入れていません。強打者ほど一塁を埋める四球が多くなったり、走者なしで比較的警戒がなくなりソロ本塁打が多くなるような場面の偏りは想像できますが、年度間の相関はほぼ 0 で打者に固有の傾向があるとは言えないことが理由です。
検証
完成したので Baseball Prospectus の DRC+、FanGraphs の wRC+ との比較検証に移ります。
分布と相関
以下は、標準偏差の比較と DRC+(BP)と wRC+ との相関係数です。
| 指標の標準偏差と相関 | |||||||
| 300打席以上 | |||||||
| シーズン | 打者数 |
標準偏差
|
自作 DRC+ との相関係数
|
||||
|---|---|---|---|---|---|---|---|
| 自作 DRC+ | 打席数あり | wRC+ | DRC+ (BP) | wRC+ | DRC+ (BP) | ||
| 2021 | 260 | 19.8 | 18.8 | 23.9 | 20.1 | 0.887 | 0.914 |
| 2022 | 276 | 19.1 | 18.1 | 24.9 | 19.8 | 0.867 | 0.893 |
| 2023 | 291 | 18.3 | 17.3 | 23.8 | 18.6 | 0.868 | 0.911 |
| 2024 | 284 | 18.1 | 17.1 | 24.0 | 20.0 | 0.874 | 0.890 |
| 2025 | 277 | 17.4 | 16.4 | 23.1 | 19.4 | 0.863 | 0.907 |
| 2026 | 266 | 15.5 | 14.8 | 20.2 | 17.8 | 0.837 | 0.875 |
DRC+(BP)との相関係数は 0.9 前後で wRC+ よりは高くなっています。wRC+ との相関係数は 0.84 ~ 0.89 で表には載せていませんが、DRC+(BP)と wRC+ との相関係数は 0.85 ~ 0.90 ですので、少しだけ Baseball Prospectus より wRC+ との距離がありそうです。
標準偏差は若干 DRC+(BP)より小さいですが、wRC+ と比較するとどちらも縮小推定の特徴が出ています。以下の分布図からも特徴が分かります。
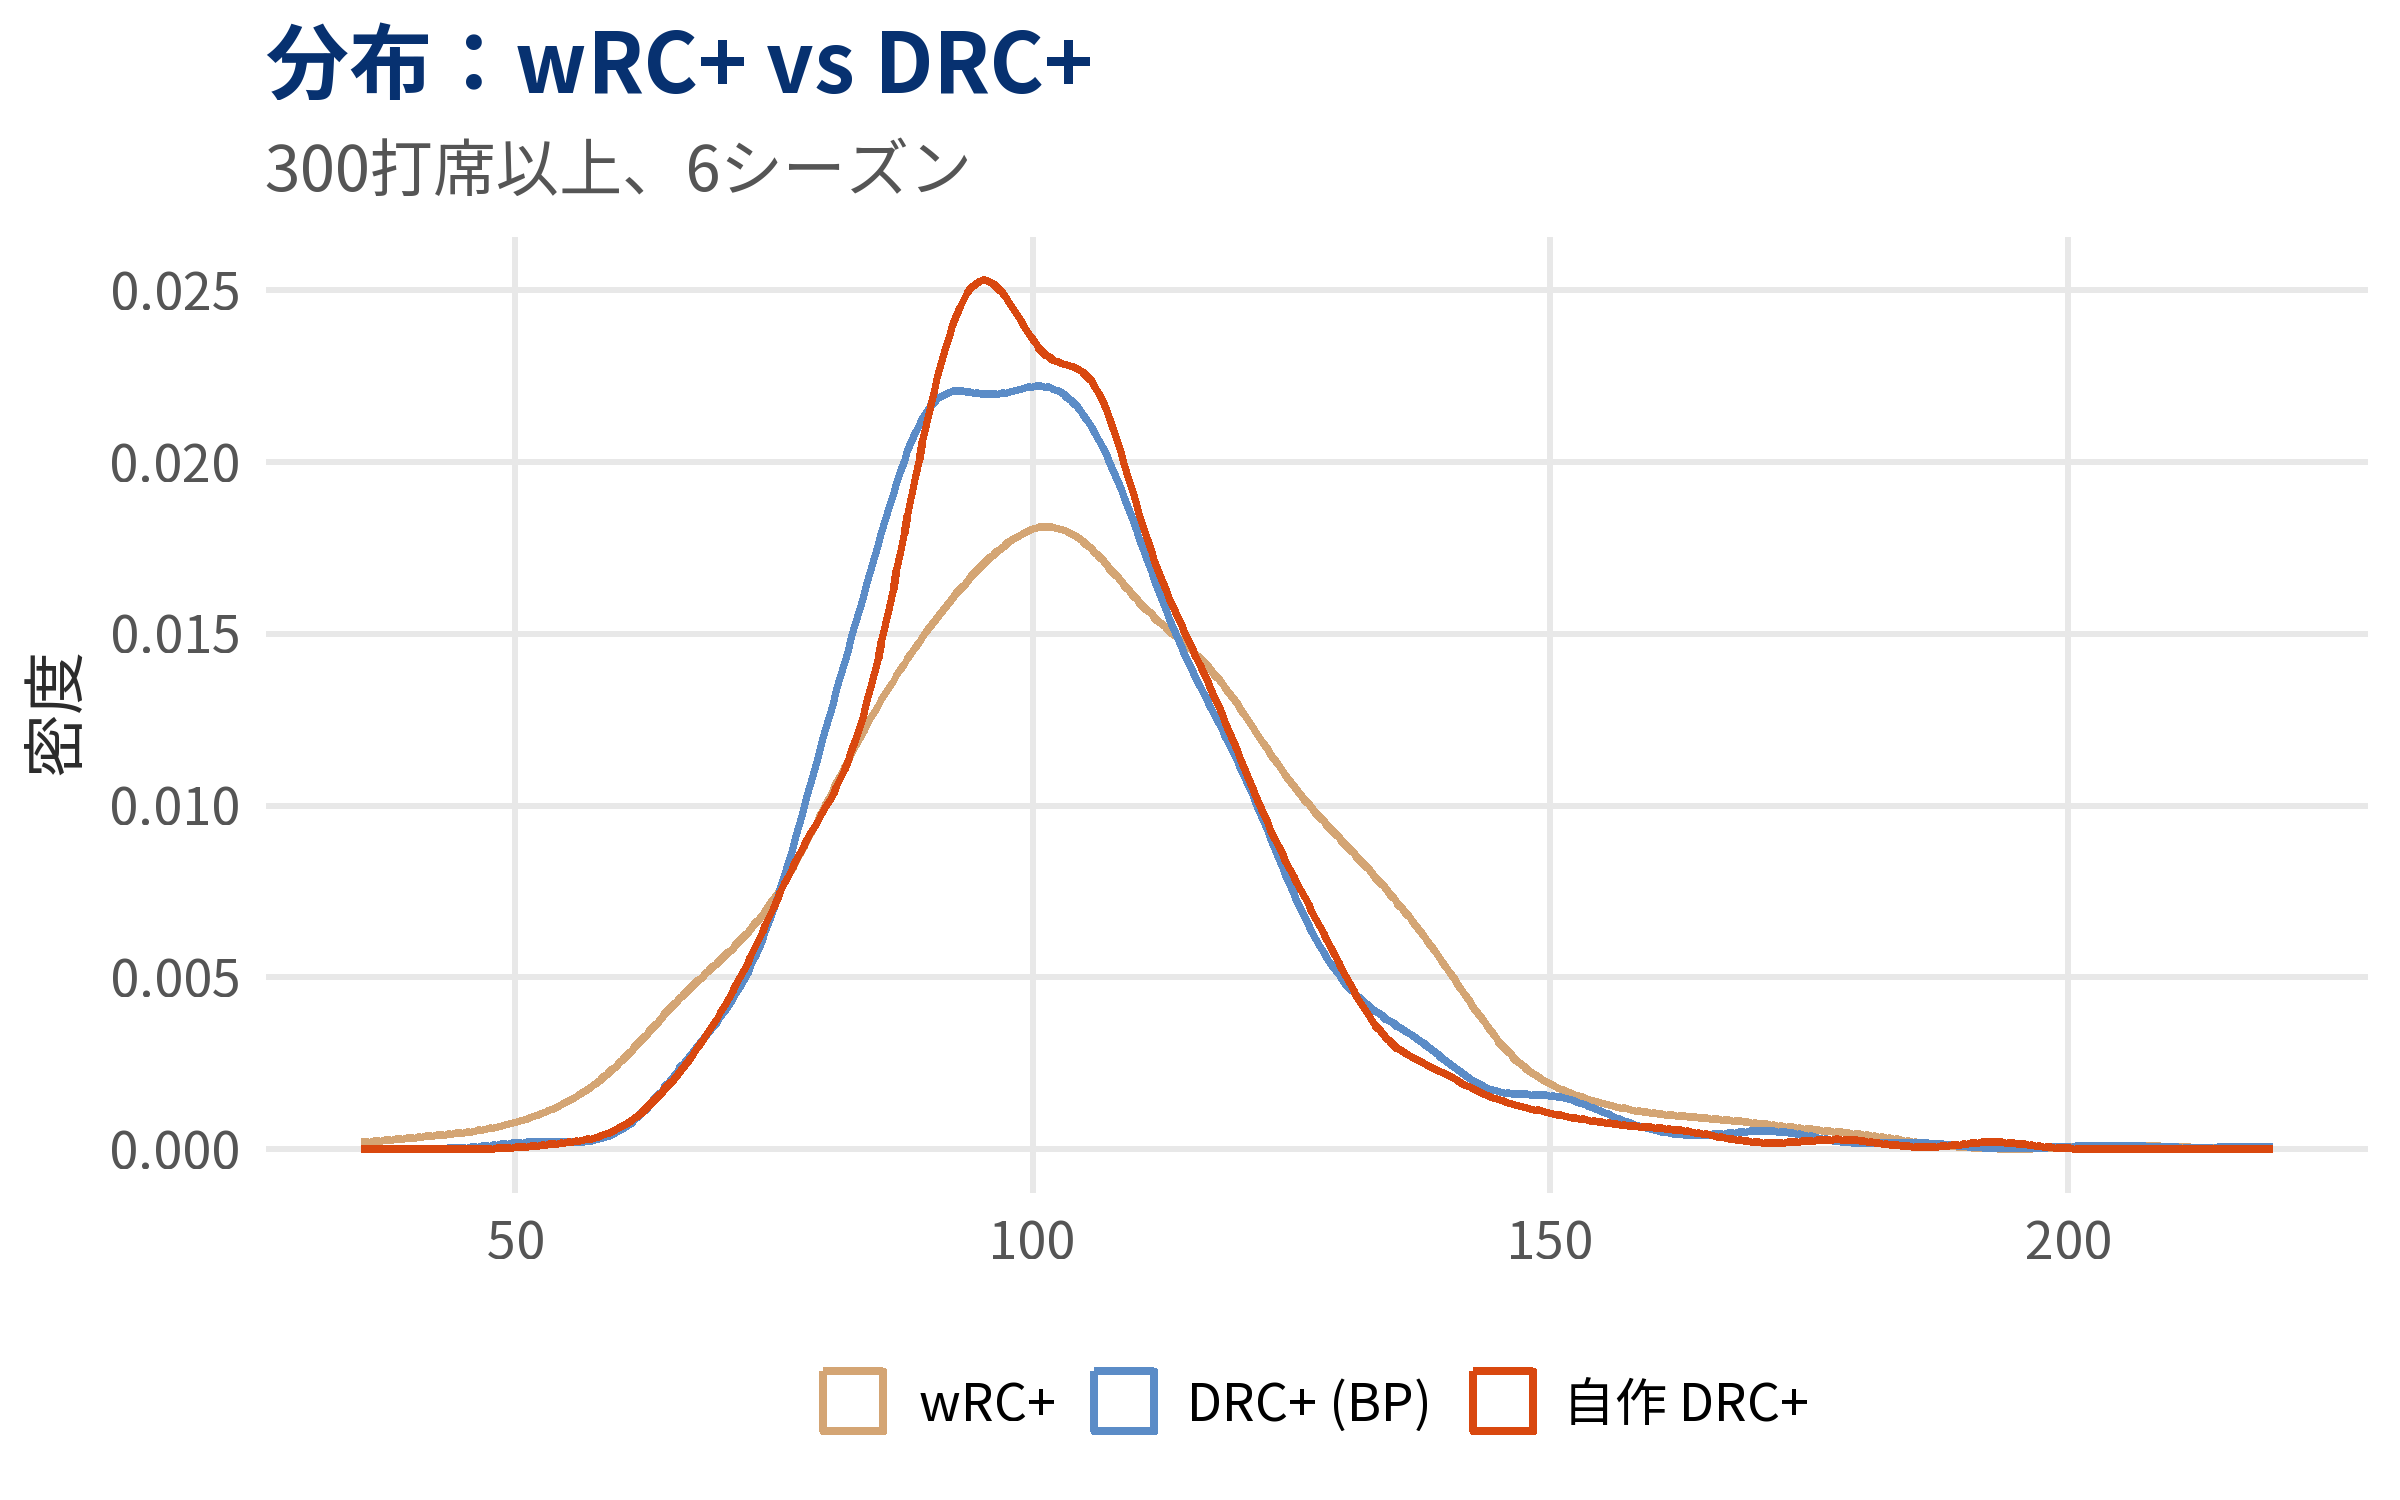
記述性
ここからは 2 種類の xwOBA(打球速度・垂直角度・走力を使うものと、それに水平角度を加えたもの)も加えて特徴を探ります。
まずは記述性です。ここでは、塁アウト状況を調整した RE24 / PA を記述性の指標とします。
| 同年の記述性 | ||
| 状況調整済み RE24 / PA との相関 | ||
| 指標 | 全員 | 300打席以上 |
|---|---|---|
| wRC+ | 0.904 | 0.900 |
| DRC+ (BP) | 0.742 | 0.808 |
| xwOBA(速度・角度) | 0.792 | 0.796 |
| xwOBA(+水平角度) | 0.832 | 0.834 |
| 自作(打席数あり) | 0.767 | 0.794 |
| 自作 DRC+ | 0.748 | 0.797 |
当然ですが、wRC+(0.904)が最も高く、縮小をかける指標は低くなります。特にこれだけでは良し悪しを語れませんが、思いのほか xwOBA(水平角度なし)が高いなという印象を受けました。
一貫性
では、翌年の同じ指標との相関を見ます。
| 一貫性:年度間相関 | ||||
| 打席数で重みづけ | ||||
| 指標 | 全員 | 両年300打席以上 | 移籍した打者 | 前年300打席未満 |
|---|---|---|---|---|
| wRC+ | 0.392 | 0.516 | 0.313 | 0.138 |
| DRC+ (BP) | 0.632 | 0.641 | 0.620 | 0.378 |
| xwOBA(速度・角度) | 0.549 | 0.648 | 0.482 | 0.286 |
| xwOBA(+水平角度) | 0.493 | 0.612 | 0.420 | 0.229 |
| 自作(打席数あり) | 0.638 | 0.668 | 0.613 | 0.331 |
| 自作 DRC+ | 0.660 | 0.663 | 0.655 | 0.396 |
両年 300 打席以上、移籍した打者(便宜上、主要チームが 2 年で違えば移籍した打者としている)、前年 300 打席未満のカテゴリすべてで、自作 DRC+ の一貫性の高さが目立ちます。先述したように、打席数を含めた版では前年 300 打席未満のレギュラー水準の打者のズレが影響として大きく、DRC+(BP)と比べてもそのカテゴリの低さが目立ちます。
予測性
翌年の wRC+ との相関です。
| 予測性:翌年の wRC+ | ||||
| 打席数で重みづけ | ||||
| 指標 | 全員 | 両年300打席以上 | 移籍した打者 | 前年300打席未満 |
|---|---|---|---|---|
| wRC+ | 0.392 | 0.516 | 0.313 | 0.138 |
| DRC+ (BP) | 0.477 | 0.557 | 0.414 | 0.204 |
| xwOBA(速度・角度) | 0.453 | 0.557 | 0.374 | 0.203 |
| xwOBA(+水平角度) | 0.436 | 0.561 | 0.356 | 0.180 |
| 自作(打席数あり) | 0.467 | 0.579 | 0.375 | 0.168 |
| 自作 DRC+ | 0.496 | 0.581 | 0.420 | 0.218 |
こちらも自作 DRC+ がすべてのカテゴリで上回りましたが、その差はそこまで大きくなく、xwOBA でも十分に戦えてはいます。
傾き
「指標が 1 高い打者は、翌年の wRC+ が平均でどれだけ高いか」を比較すると、自作 DRC+ は 0.88、DRC+(BP)は 0.78 でした。1 に近いほど、指標の差がそのまま翌年の差として現れます。
この傾きが弱点になるのが wRC+(0.42)はもちろん、xwOBA です。xwOBA は水平角度ありで 0.53、なしでも 0.56 と縮小推定をしない弱さが出ます。順位を予測として使うのと、数値を予測として使うのではその危険性に違いがある指標ということに注意が必要です。
打者タイプによるバイアス
特定のタイプの打者を、系統的に見誤っていないかを調べます。翌年の wRC+ を予測し、そのズレを打者のタイプ(三振率、四球率、本塁打率、走力、打席の左右)で説明できるかを見ます。
| 打者タイプによるバイアス | |||||
| 翌年の wRC+ との残差を前年の三振率などで回帰したときのt値、2が目安(200打席以上) | |||||
| 打者タイプ | wRC+ | DRC+ (BP) | xwOBA(+水平角度) | 自作(打席数あり) | 自作 DRC+ |
|---|---|---|---|---|---|
| 三振率 | −0.96 | 0.91 | 0.17 | −0.31 | 0.95 |
| 四球率 | 2.54 | 0.99 | 1.43 | −0.95 | −0.71 |
| 本塁打率 | 1.93 | 0.90 | 0.49 | 0.85 | 0.30 |
| 一塁到達タイム | −1.34 | −3.01 | −1.65 | −0.17 | −0.37 |
| 左打席 | 0.26 | 1.17 | 0.25 | 0.42 | 0.42 |
wRC+
四球率でバイアスが残ります(t = +2.54)。四球の多い打者を低く見積もっているということです。四球率は一貫性が高いのに対して、wRC+ では他と同じ重みで扱われる部分が弱点となっています。
DRC+
走力でバイアスが残ります(t = −3.01)。一塁到達タイムが遅い打者を高く見積もっているという結果です。
自作版
完成させてからこのバイアス検証をしたので、割と驚きではありましたが、自作版ではすべてで 1 未満でした。ここは強みと言えますが、他のバイアスを網羅して検証できているわけではないのは注意点です。
球場によるバイアス
球場によるバイアスも調べましたが、サンプルサイズ的に検出力が足りず、結論は出しにくいというのが結論です。
Baseball Prospectus の DRC+ 関連の記事でも触れられている Coors Field を本拠地にする打者についても調べましたが、6 シーズン分ではやはり言えることが少ないです。
強いて言うならば、自作 DRC+ は Baseball Prospectus の DRC+ よりは wRC+ 寄りになっています。Coors Field のデバフに対応するには今回の構築過程とは全く毛色の違う手法が必要だと考えているので、検証含めて次回以降の課題です。
不確実性
推定値に付けた不確実性が適切かどうかも検証します。2024 年を分割し、片方の半分から作った推定値と標準偏差で、もう片方の半分の実際の成績を予測します。外れの大きさを「推定の不確実性 + 状況中立の得点価値の偶然の振れ」で割った値(標準化した予測誤差、ここでは z と呼ぶ)の標準偏差が 1 に近ければ、幅が適切と見なせます。
| 区間の幅の検証 | ||||||
| 2024を分割、z の標準偏差が1 | ||||||
| もう半分の打席数 | 打者数 | 推定の標準偏差 | 状況中立RVの標準誤差 | z の平均 | z の標準偏差 | 90%区間に入った割合 |
|---|---|---|---|---|---|---|
| 100〜199 | 321 | 14.4 | 28.9 | −0.07 | 1.05 | 0.89 |
| 200〜299 | 275 | 13.0 | 23.0 | 0.03 | 1.01 | 0.89 |
| 300以上 | 137 | 12.4 | 20.6 | 0.25 | 1.03 | 0.85 |
| 全体 | 733 | 13.5 | 25.1 | 0.03 | 1.04 | 0.89 |
z の標準偏差は 1.04、90% 区間に入った割合は 0.885 でした。わずかに狭い側ですが、ほぼ適切です。もう片方の半分には、対戦相手や球場の違いも含まれるので、幅が完全に正しくても 1 をわずかに上回るはずです。
また、前章で Baseball Prospectus の DRC+ SD の算出方法が公表されていないことに触れました。個人的に気になる部分なので、値そのものを比べてみます。
| 推定の不確実性:Baseball Prospectus との比較 | ||||||
| 打席数 | 打者数 |
「+」の単位
|
状況中立RVの標準誤差との比
|
|||
|---|---|---|---|---|---|---|
| 状況中立RVの標準誤差 | 自作 DRC+ | DRC+ (BP) | 自作 DRC+ | DRC+ (BP) | ||
| 100〜299 | 1118 | 25.4 | 14.2 | 19.6 | 0.56 | 0.78 |
| 300〜499 | 849 | 17.8 | 11.4 | 16.7 | 0.64 | 0.94 |
| 500以上 | 804 | 15.0 | 10.1 | 15.8 | 0.67 | 1.05 |
| 状況中立RVの標準誤差:補正も縮小もしない打席あたり状況中立得点価値の標準誤差 | ||||||
500 打席以上の打者で、状況中立得点価値(ほぼ wOBA)の偶然の振れが平均 15.0 なのに対し、自作版の標準偏差は 10.1、Baseball Prospectus は 15.8 です。Baseball Prospectus の値は、縮小をかけていない成績の振れとほぼ同じ大きさです。
縮小推定では、不確実性は wOBA のような指標の偶然の振れ(Random Variation)より小さくなるのが普通です。Baseball Prospectus の幅がそれと同じ大きさだということは、ほとんど縮小していないか、別の種類の不確実性を足しているかです。
以下は、実際のイベントごとの確率と DRC+ で推定する Deserved なイベントごとの確率との比較を示した表です。Baseball Prospectus の Deserved Rates タブに載っている数値です。
| 実際のイベント確率とDeserved Ratesの比較 | |||||
| 300打席以上 | |||||
| イベント |
幅の比(推定 ÷ 実際)
|
相関係数
|
|||
|---|---|---|---|---|---|
| BP | 自作 | 実際の率と BP | 実際の率と自作 | BP と自作 | |
| 単打 | 0.66 | 0.81 | 0.91 | 0.85 | 0.95 |
| 二塁打 | 0.47 | 0.42 | 0.71 | 0.63 | 0.57 |
| 三塁打 | 0.51 | 0.40 | 0.88 | 0.88 | 0.89 |
| 本塁打 | 0.94 | 0.81 | 0.88 | 0.91 | 0.90 |
| 四球 | 0.87 | 0.78 | 0.99 | 0.98 | 0.98 |
| 三振 | 0.93 | 0.93 | 0.99 | 0.99 | 0.99 |
影響が大きそうなのが、本塁打率です。Baseball Prospectus の Deserved の本塁打率は、実際の本塁打率の幅の 94% を保っています(自作版は 81%)。
これは、以前(いつかのアップデート)から不思議に思っていたこととつながります。縮小されるはずの最上位の強打者の DRC+(BP)が、wRC+ と思いのほか一致するという現象です。上位打者の価値の多くは本塁打と四球からくるので、そこをほとんど縮めなければ、上位打者の DRC+ は wRC+ に近くなります。そして、実際の成績を強く信用するほど、不確実性はその実際の成績の振れに近づきます。
本塁打は、Statcast データを使ってもなお 1 割ほど割り引く必要があったことを考えると、94% を残す Baseball Prospectus 側には疑問が残るというのが正直なところです。翌年の成績に対する傾きも DRC+(BP)の方が低く、当年の貢献度という推定対象は前提に置きながらも、当年の DRC+ に対しての縮小量は不足している感が否めません。先述した不確実性の幅の検証からも、自作版の標準偏差が小さいとは言いにくいので、次回以降の検証更新でこの点についても再度考えてみたいと思います。
おわりに
Baseball Prospectus の DRC+ を「完成しない指標」と書きましたが、自作版も同じです。ただ、どこが弱そうかを自分で把握できているという点で、ブラックボックスを眺めるより気持ちは楽です。
完成させて記事にまとめている段階で、さらに無数の改善候補が思いついてしまったので、また暇なときにアップデートしていければと思います。
コードについてもまとめられたら公開するかもしれません。
参考文献
Baseball Prospectus. 2026. “Baseball Prospectus.” https://www.baseballprospectus.com/.
FanGraphs. 2026. “FanGraphs.” https://www.fangraphs.com/.
Grosnick, Bryan. 2018. “Introducing Deserved Runs Created Plus (DRC+).” Baseball Prospectus, December 3. https://www.baseballprospectus.com/news/article/45338/introducing-deserved-runs-created-plus-drc/.
Judge, Jonathan. 2018a. “The Performance Case for DRC+.” Baseball Prospectus, December 3. https://www.baseballprospectus.com/news/article/45383/the-performance-case-for-drc/.
Judge, Jonathan. 2018b. “Why DRC+.” Baseball Prospectus, December 3. https://www.baseballprospectus.com/news/article/45432/why-drc/.
Judge, Jonathan. 2019a. “DRC+: Updates and Improvements.” Baseball Prospectus, February 5. https://www.baseballprospectus.com/news/article/46944/DRC-updates-and-improvements/.
Judge, Jonathan. 2019b. “Entirely Beyond WOWY: A Breakdown of DRC+.” Baseball Prospectus, April 8. https://www.baseballprospectus.com/news/article/48293/entirely-beyond-wowy-a-breakdown-of-drc/.
Judge, Jonathan. 2021a. “An Updated System of Park Factors (and Volatility).” Baseball Prospectus, February 9. https://www.baseballprospectus.com/news/article/64534/an-updated-system-of-park-factors-and-volatility/.
Judge, Jonathan. 2021b. “Deserved Stats for the 2021 Season.” Baseball Prospectus, April 28. https://www.baseballprospectus.com/news/article/66474/deserved-stats-for-the-2021-season/.
Judge, Jonathan. 2023. “An Updated Evaluation of Hitting and Pitching (Including Stuff) Metrics.” Baseball Prospectus, May 3. https://www.baseballprospectus.com/news/article/82426/prospectus-feature-an-updated-evaluation-of-hitting-and-pitching-including-stuff-metrics/.
Judge, Jonathan. 2024. “A Patch to DRC+.” Baseball Prospectus, August 19. https://www.baseballprospectus.com/news/article/93122/bp-announcements-a-patch-to-drc/.
Mains, Rob. 2018. “Comparing DRC+, OPS+, and wRC+.” Baseball Prospectus, December 4. https://www.baseballprospectus.com/news/article/45445/comparing-drc-ops-and-wrc/.